
写在最前
Python 中定义变量时不需要声明变量类型,这是 Python 有别与 C++ 的一大特色。
定义变量
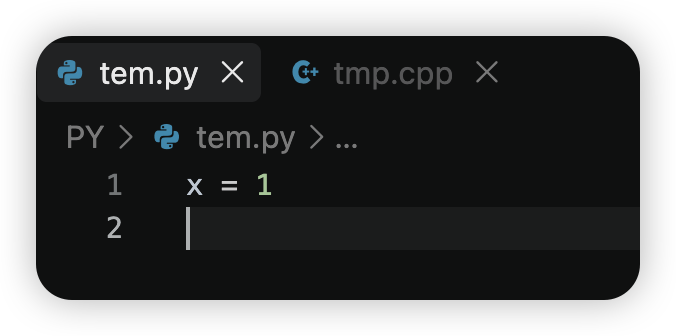
Python 中定义一个整型变量 x :
C++ 中定义一个整型变量 x : 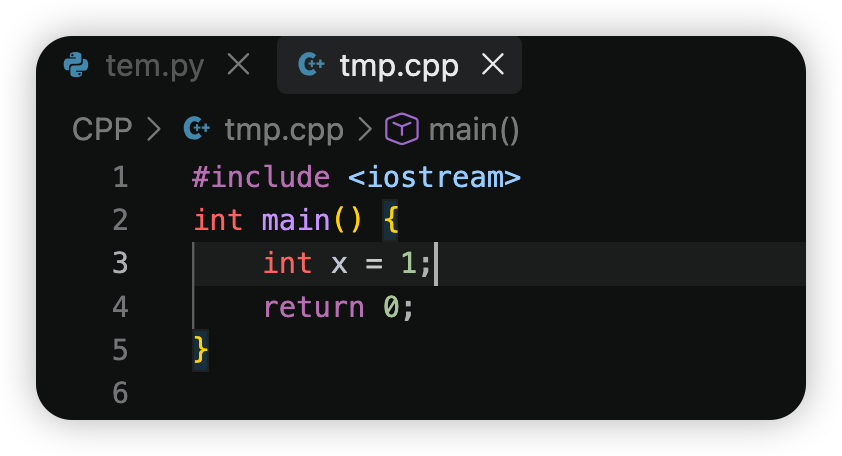
事实上,Python 中每个变量在使用前都必须赋值,变量赋值以后该变量才会被创建,变量就是变量,它没有类型,我们所说的类型是变量所指的内存中对象的类型。
等号 = 用来给变量赋值。等号左边是变量名,右边是存储在变量中的值,例子就是上面两个图。
多个变量赋值
多个变量赋值相同,例子:
a = b = c = 1多个变量赋值不同,例子:
a, b, c = 1, 2, "ZHOU"标准数据类型
在之前的文章里已经讨论过 Python 的数据类型,这里展开讲。
Python 中有 6 种标准的数据类型,以及 bool 布尔类型,而布尔类型实际上是 int 的子类,有时候会单独作为一类数据类型。
- Number(数字)
- String(字符串)
- bool (布尔类型)
- List(列表)
- Tuple(元组)
- Set(集合)
- Dictionary(字典)
按照是否可变,可以分为以下两种类型:
- 不可变数据:Number、String、bool、Tuple
- 可变数据:List、Dictionary、Set
“不可变”不代表变量不能重新赋值,而是变量所指向的那个对象不能被原地修改。 学习时,始终区分“修改对象”和“给变量重新赋值”这两个动作。
这里有一个形象的比喻:如果定义一个列表内存储字符串,每个字符串是一个纸片上印了一个单词,这个列表是存放字符串的容器,你不能直接改动纸片上的单词,但是你可以直接换张纸片。这就是“修改对象”。
此外还有一些高级数据类型,后面的文章会讨论到。
Number(数字)
Python 支持 int、float、bool、complex(复数)
在 Python3 里只有整数类型 int 表示为长整型,没有 Python2 里的 Long。
除了内置的 type() 函数可以用来查询变量所指的对象类型,还可以用 isinstance() 来判断:
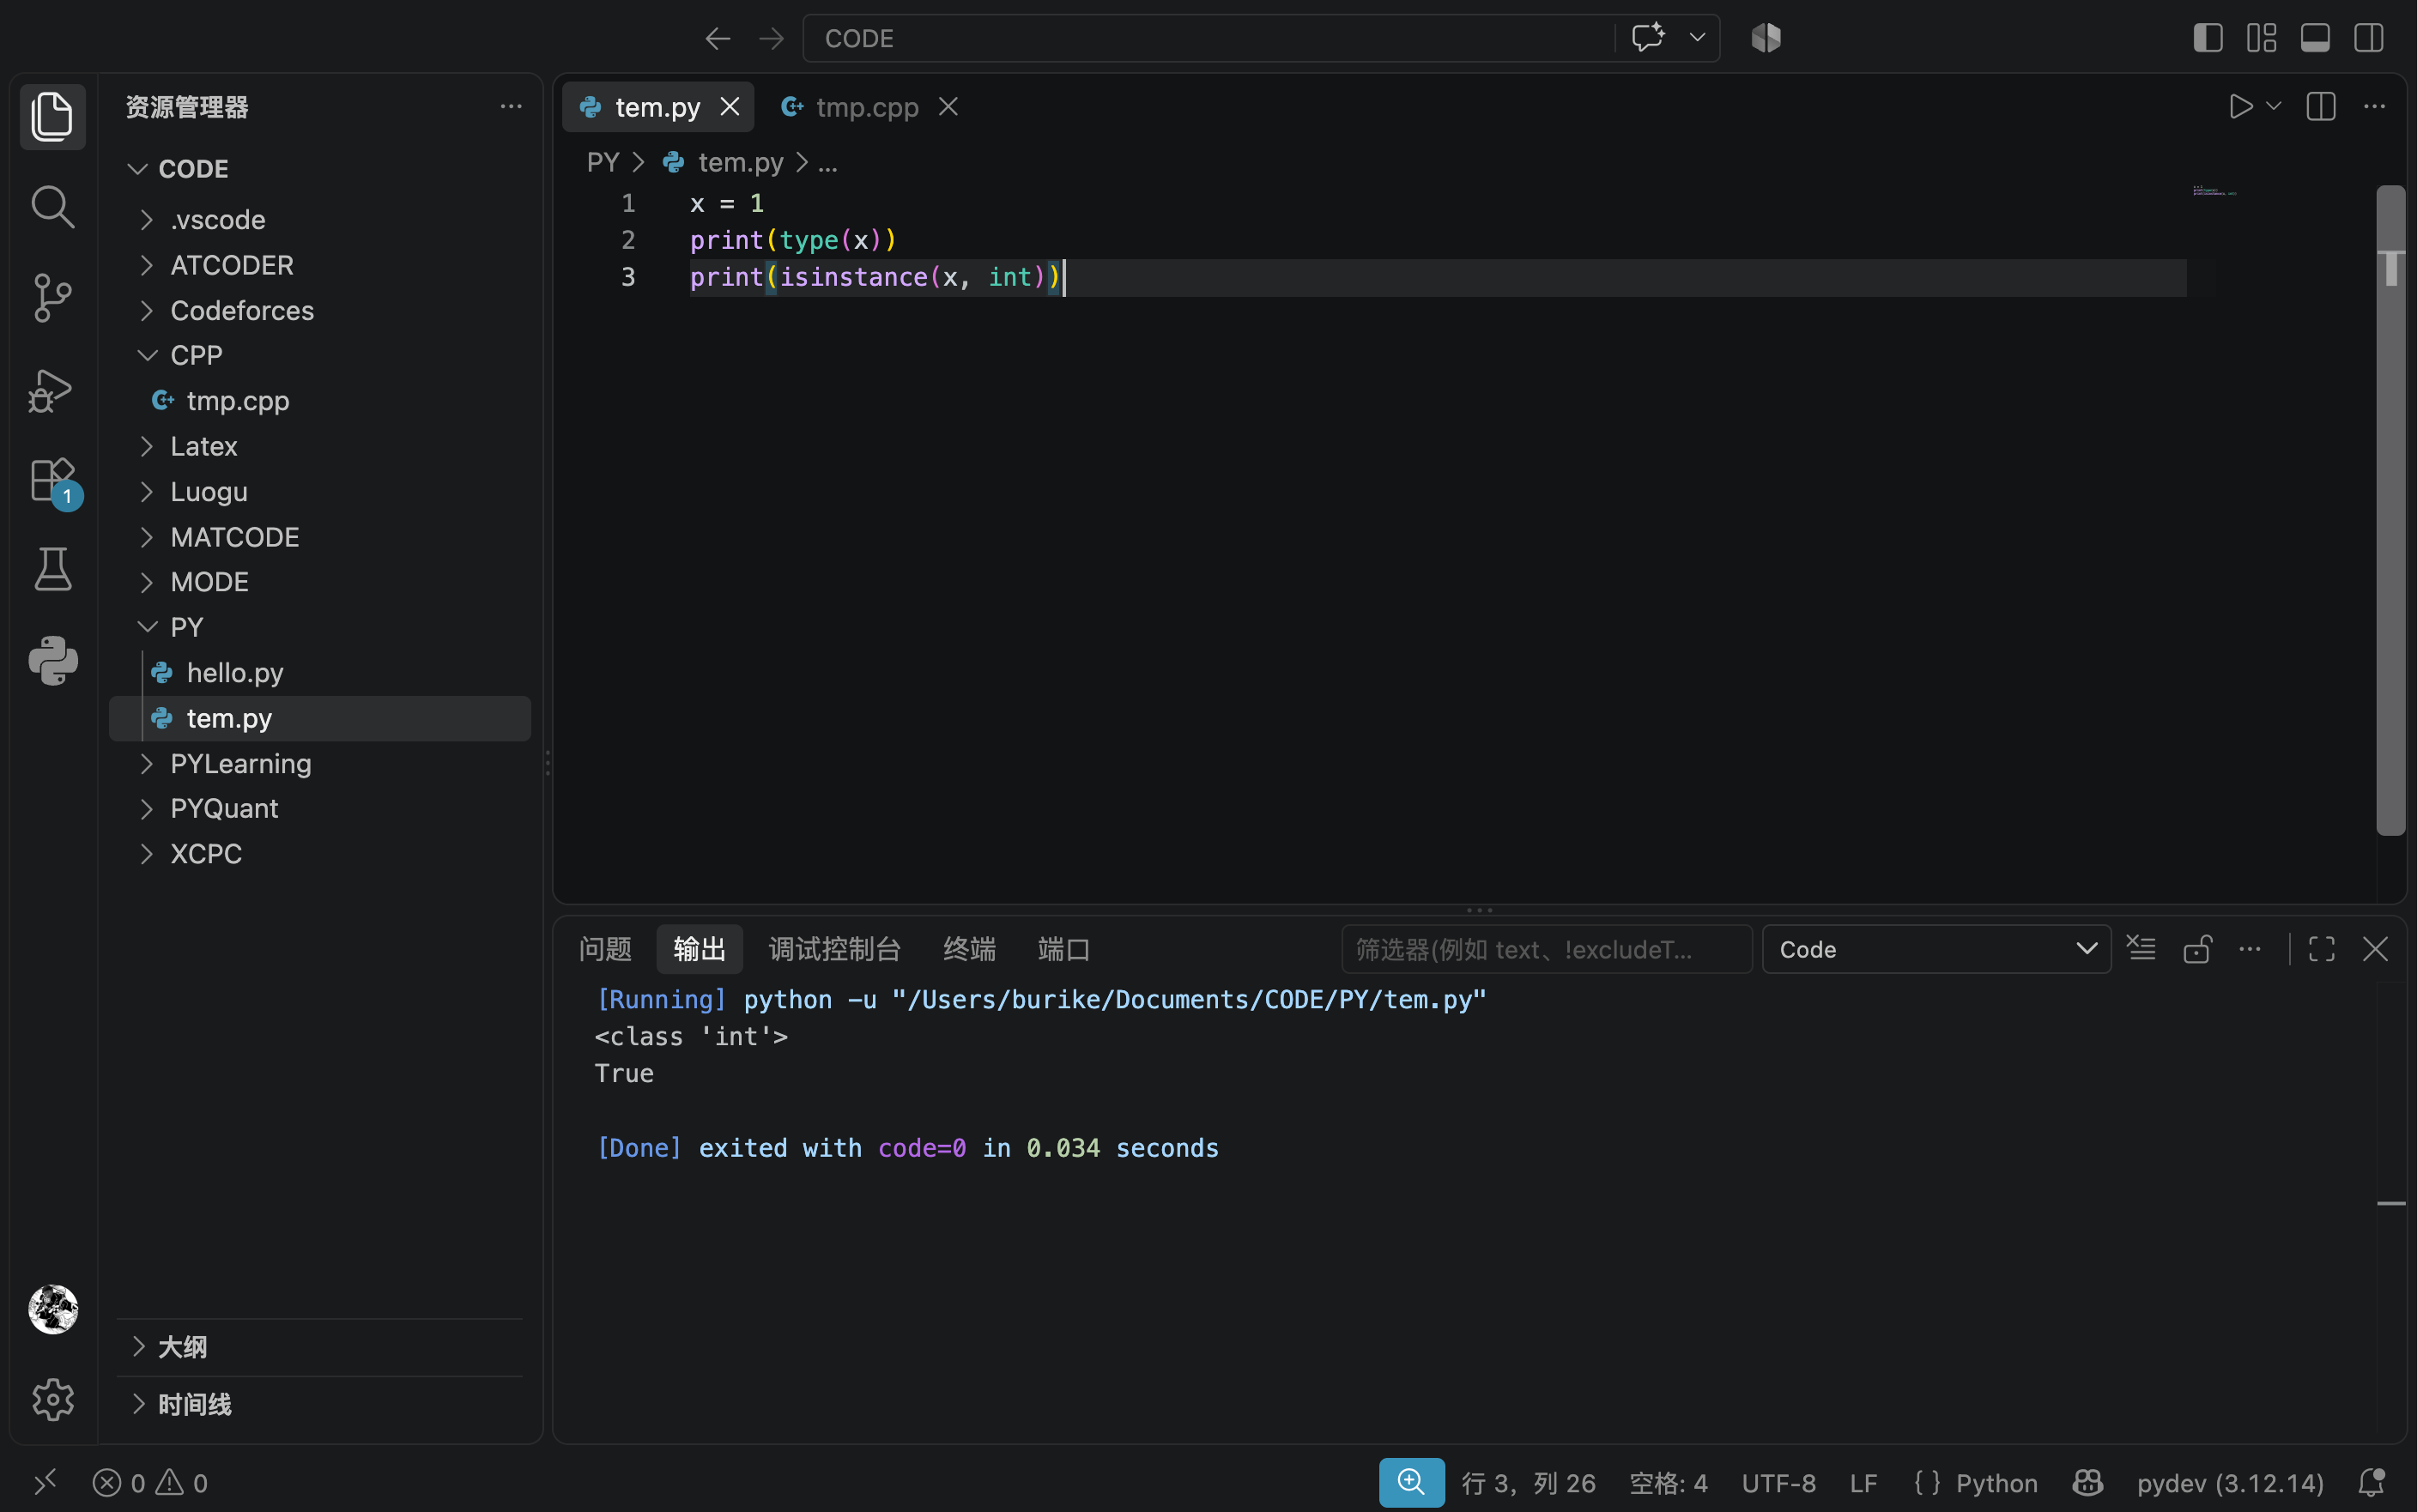
注意:isinstance() 和 type() 有一些区别,前者会认为子类是一种父亲类型,而后者不会认为子类是一种父亲类型,例如 bool 实际上是 int 的子类。参考下图代码运行结果。
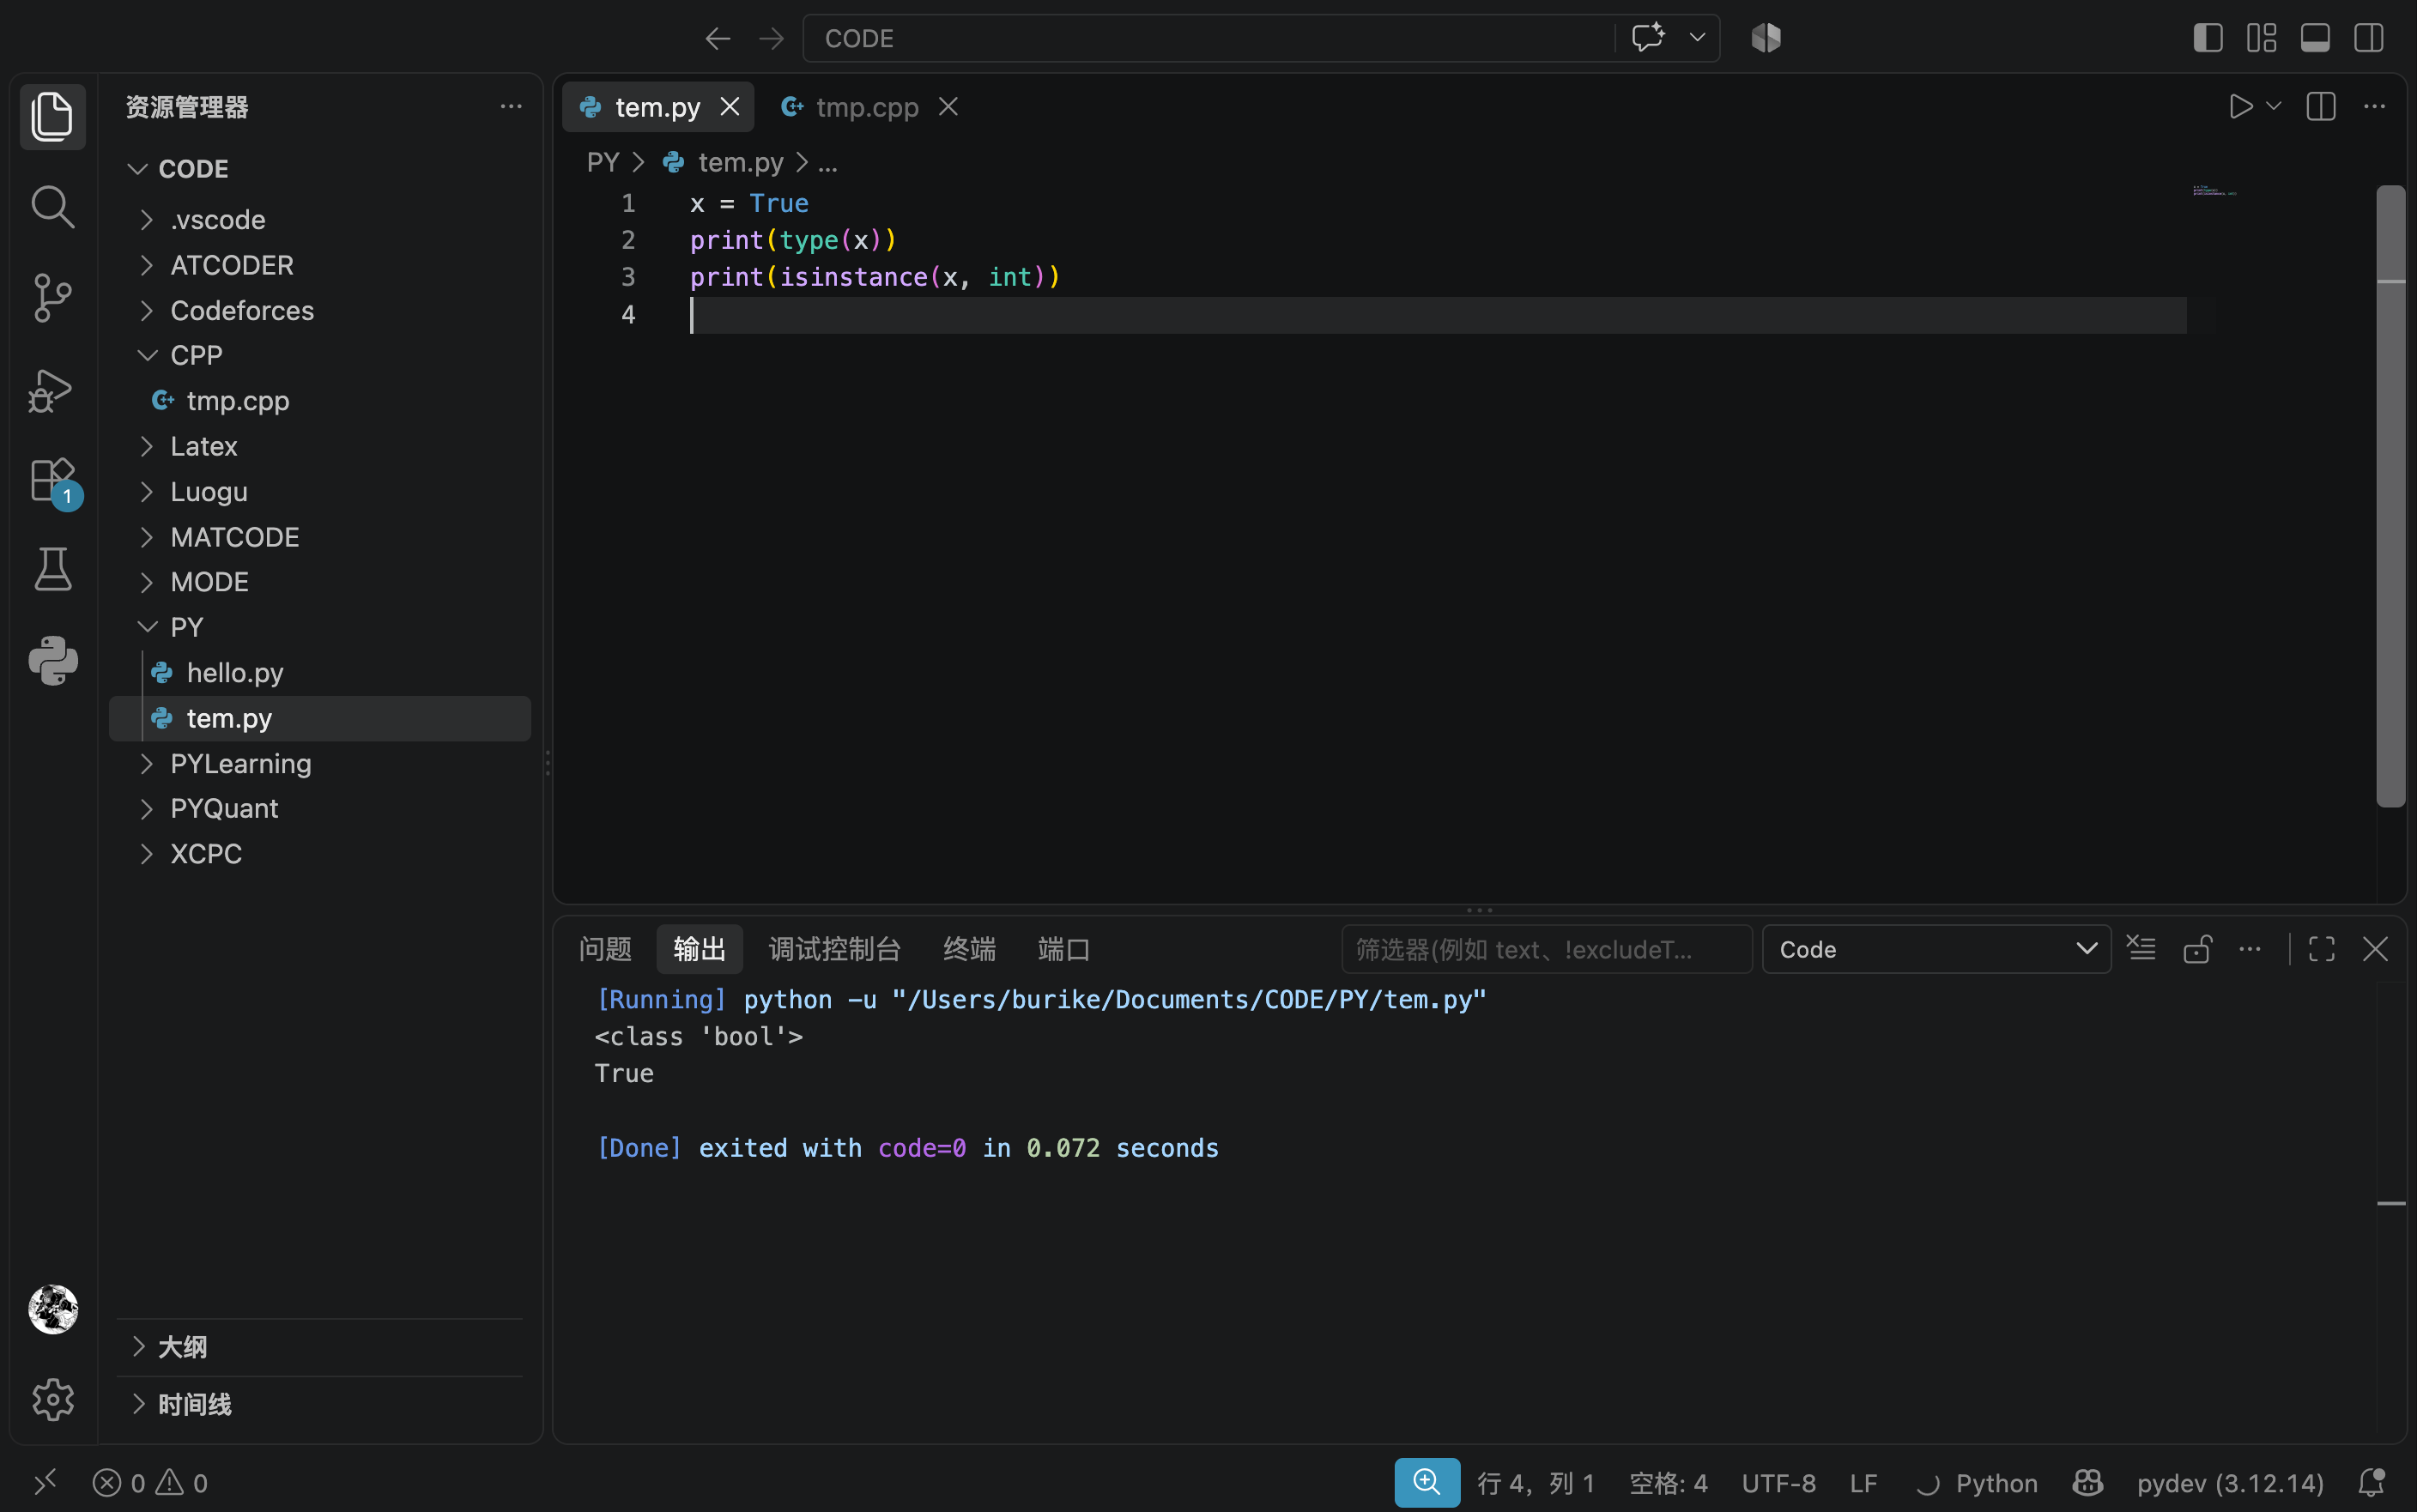
当你指定一个值,Number对象就会被创建:
x = 1
y = 10
可以使用 del 语句删除对象引用或者容器内的元素,具体用法见下:
1. 删除变量名
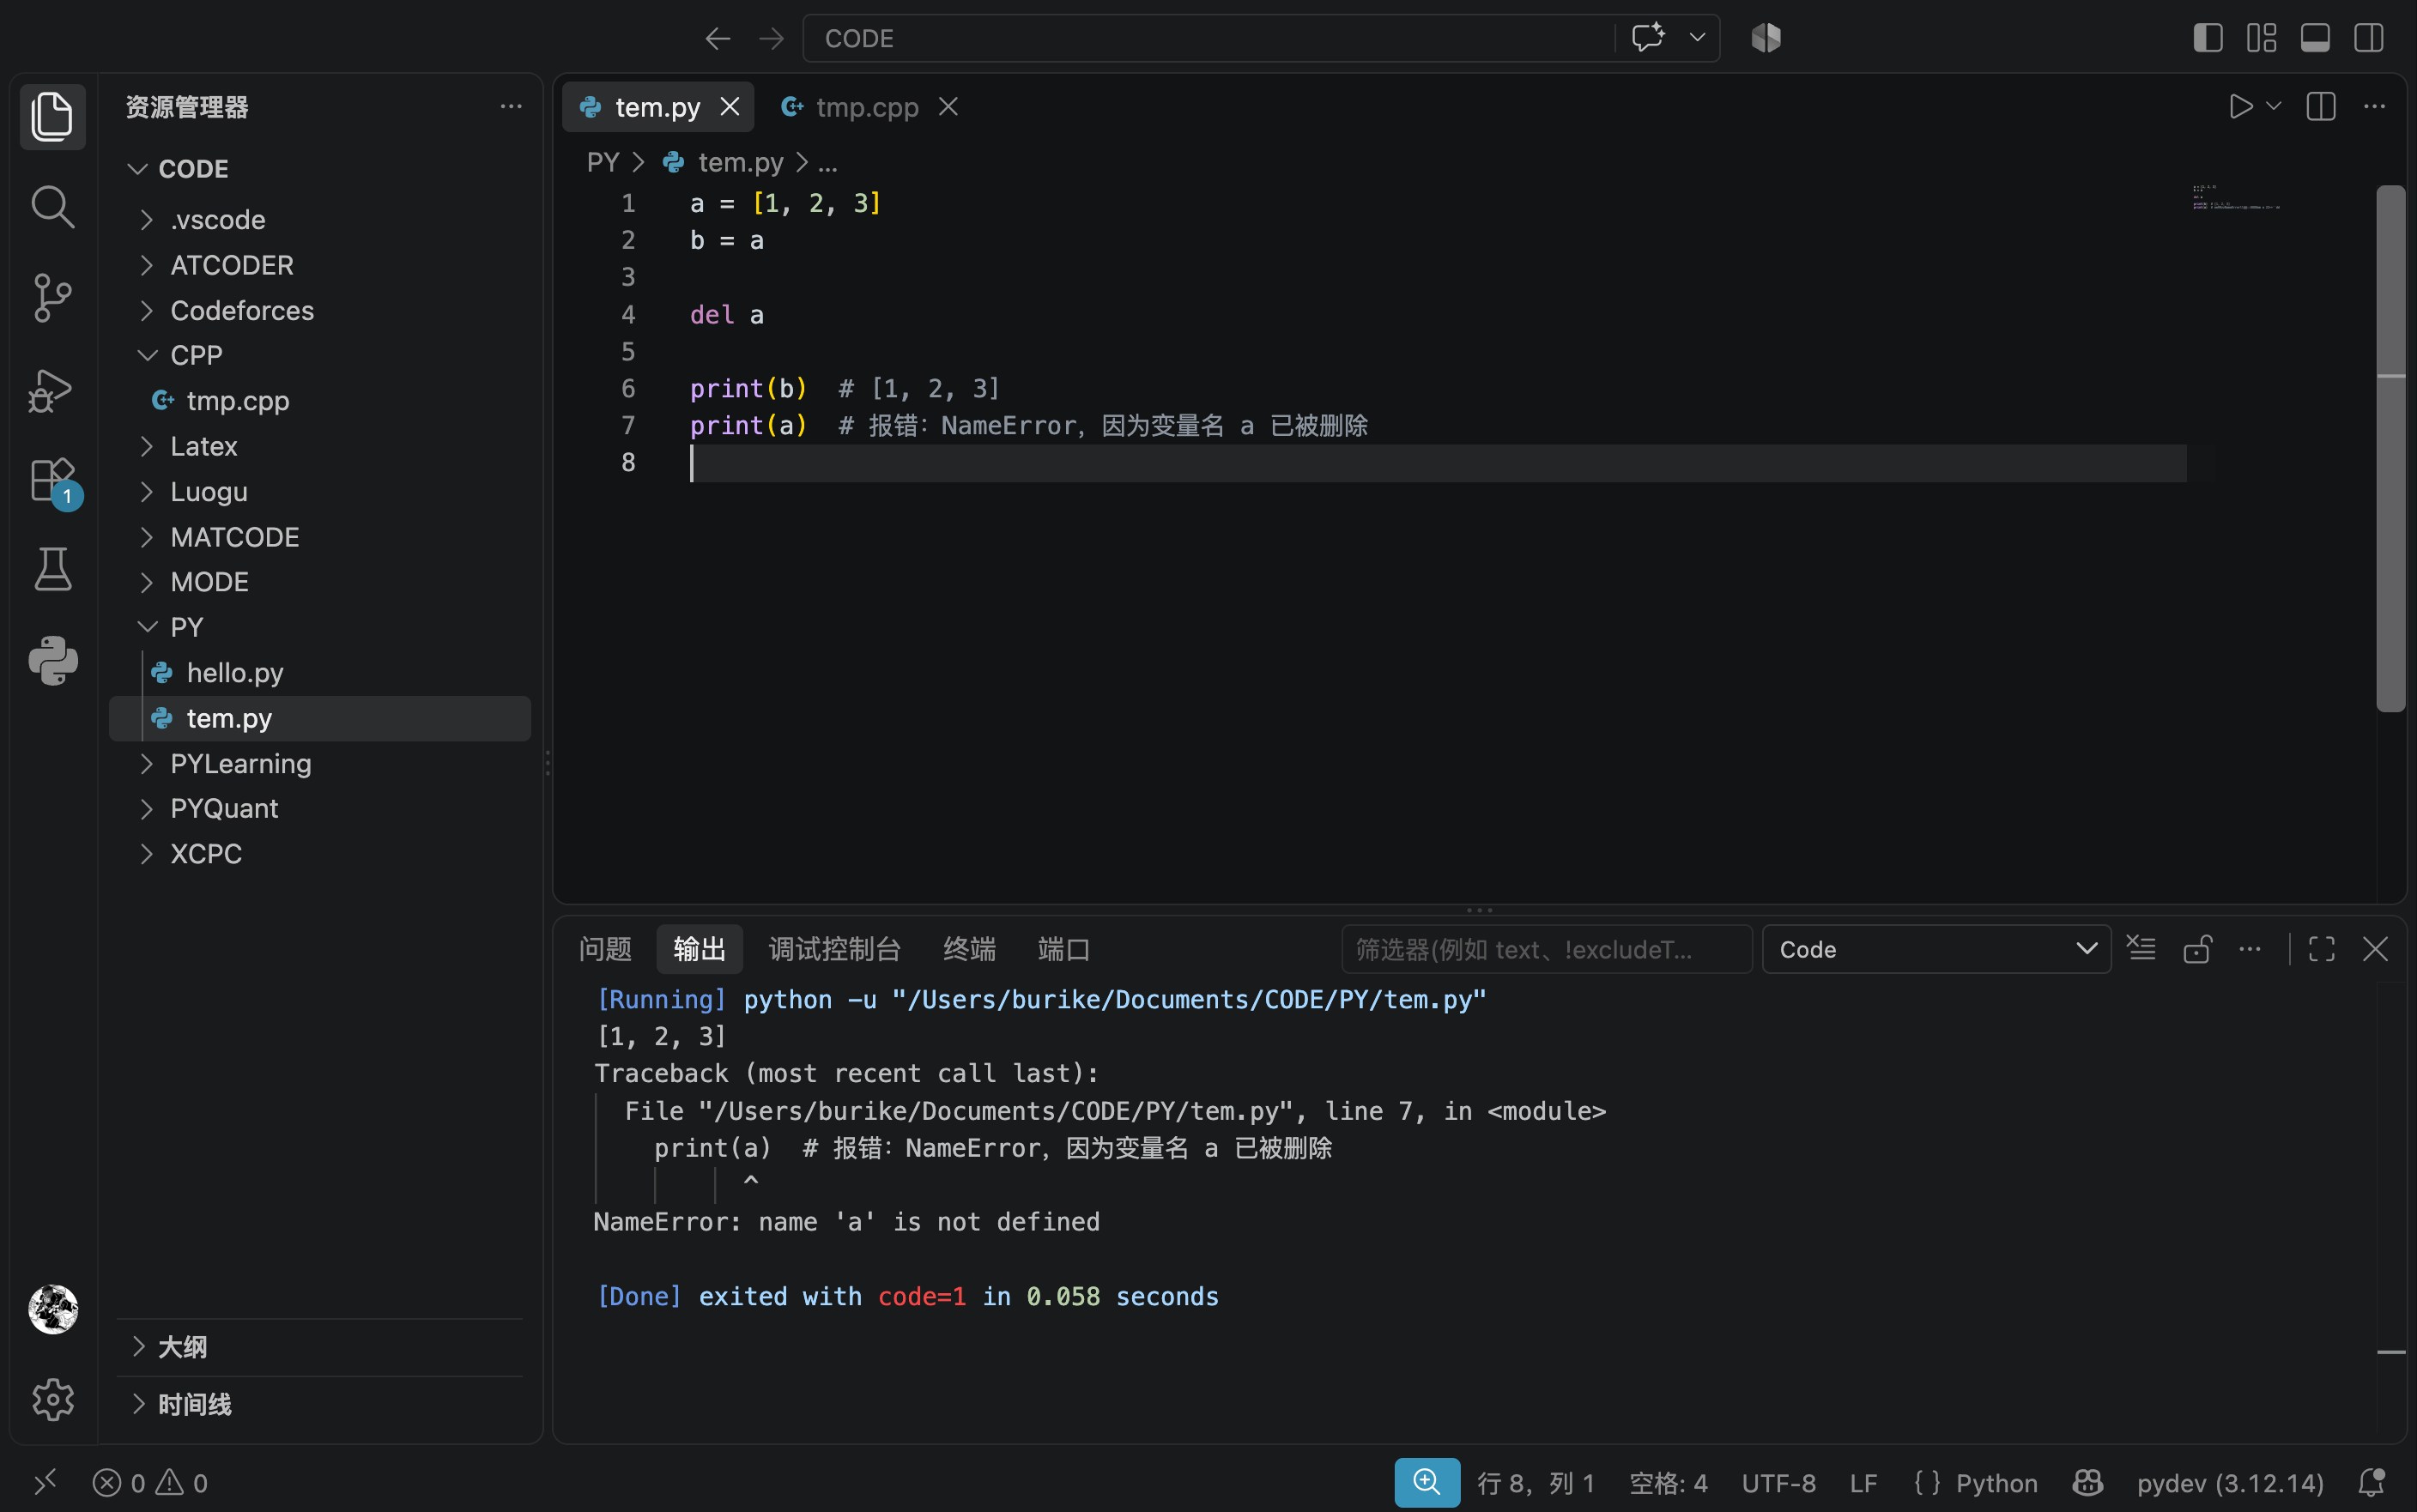
del a 删除的是 a 与对象之间的绑定关系,并不是直接销毁那个列表。因为 b 仍然指向它,所以列表仍可使用。
当一个对象不再被任何地方引用时,Python 通常就可以回收它占用的内存,如上图报错信息。
2. 删除列表中的元素
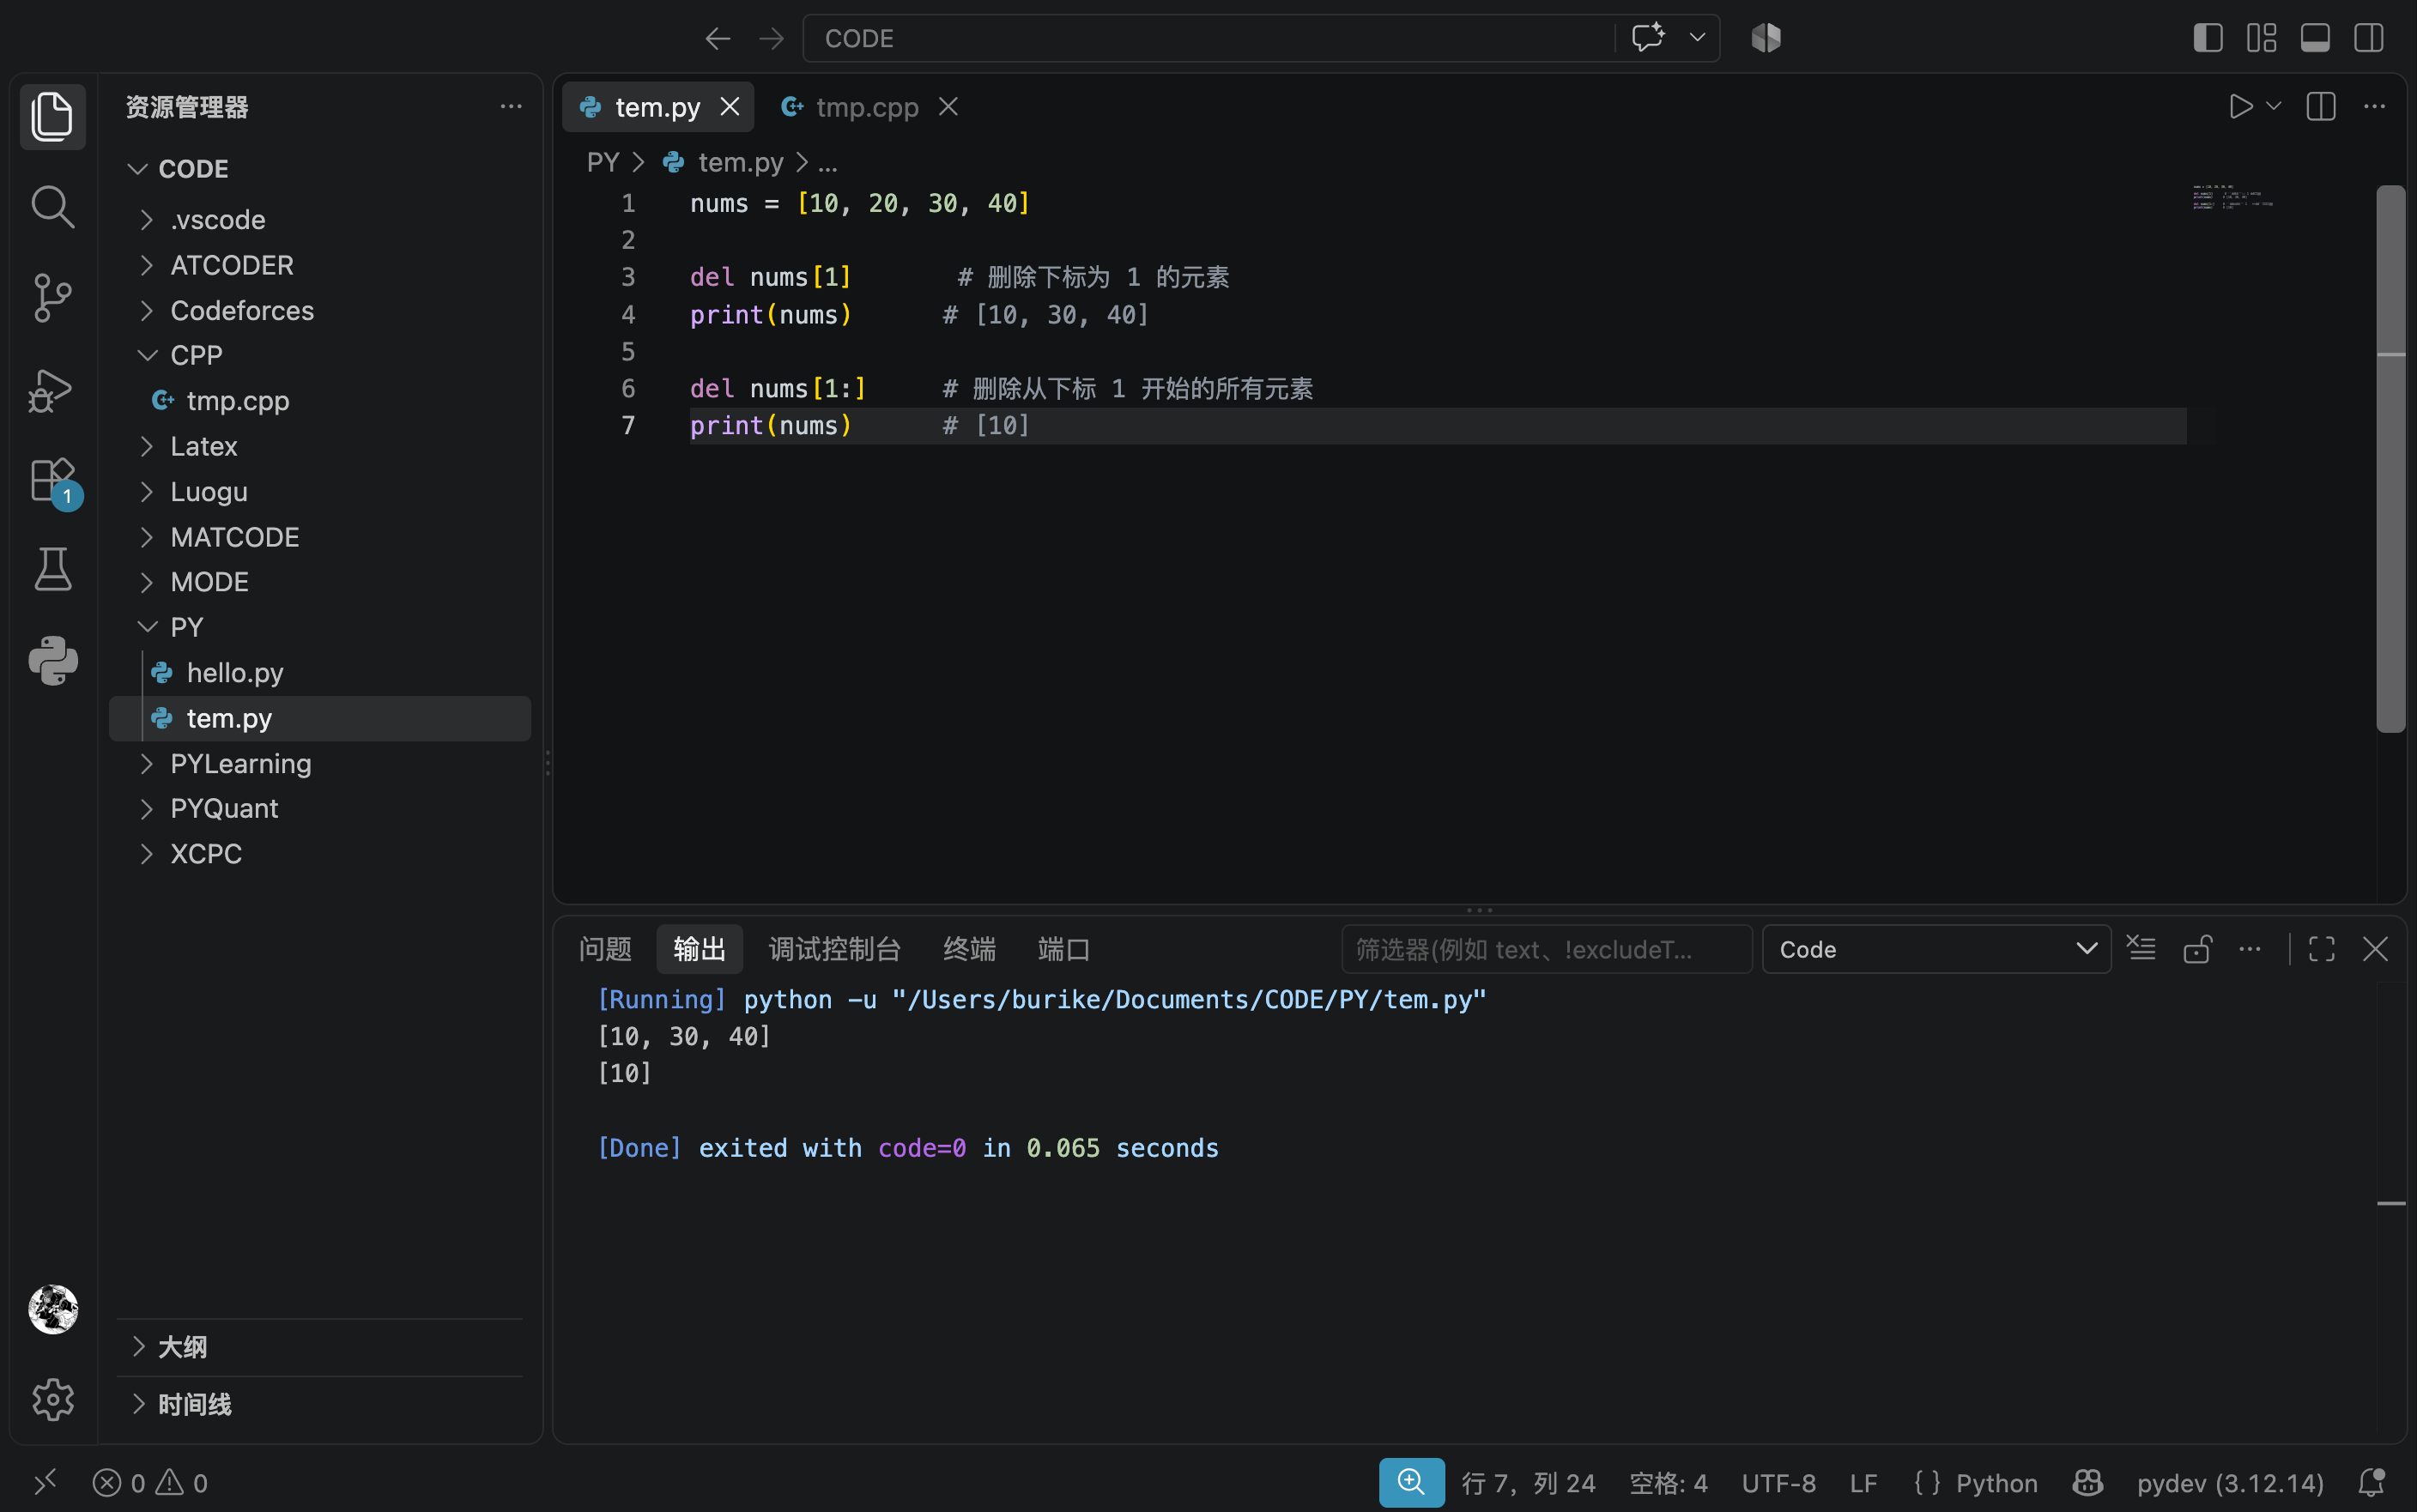
这时修改的是列表本身,变量 nums 仍然存在。
尤其要区分:
del nums[:]  # 清空列表,nums 仍然指向这个空列表
del nums     # 删除变量名 nums
3. 删除字典中的键值对
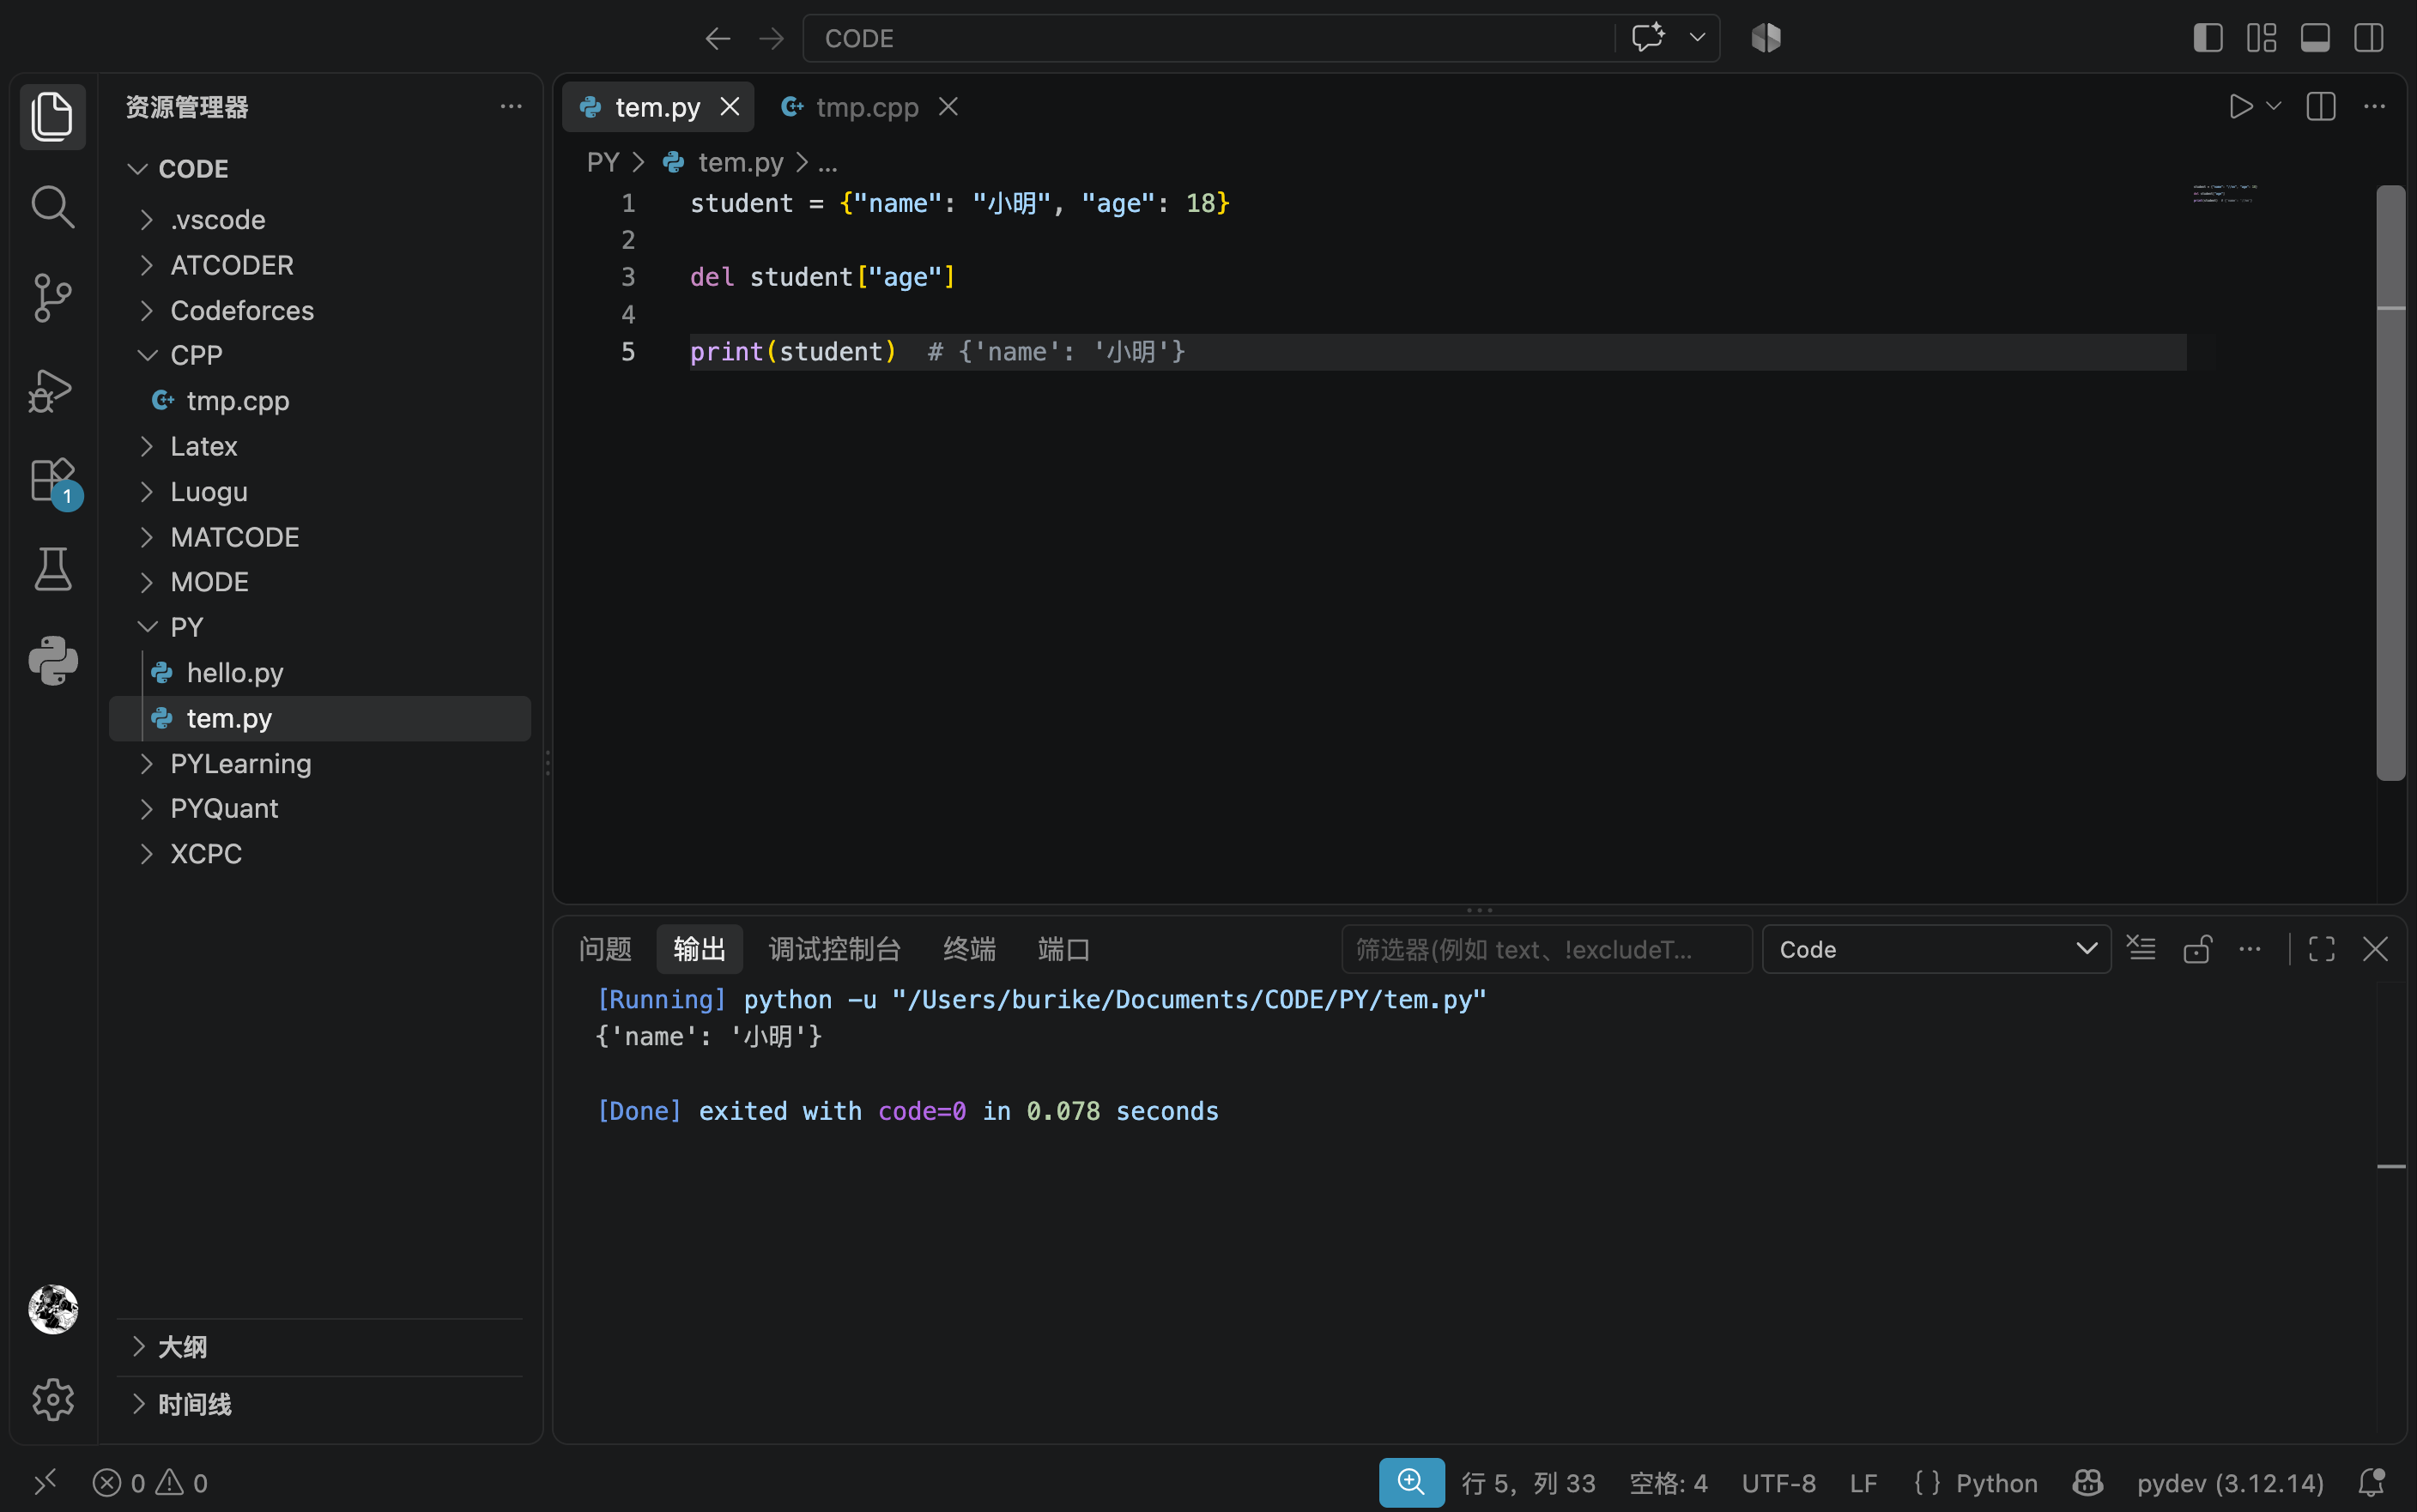
如果指定的键不存在,会报 KeyError。
4. 不可变对象可以删除变量名,但不能删除其中的元素
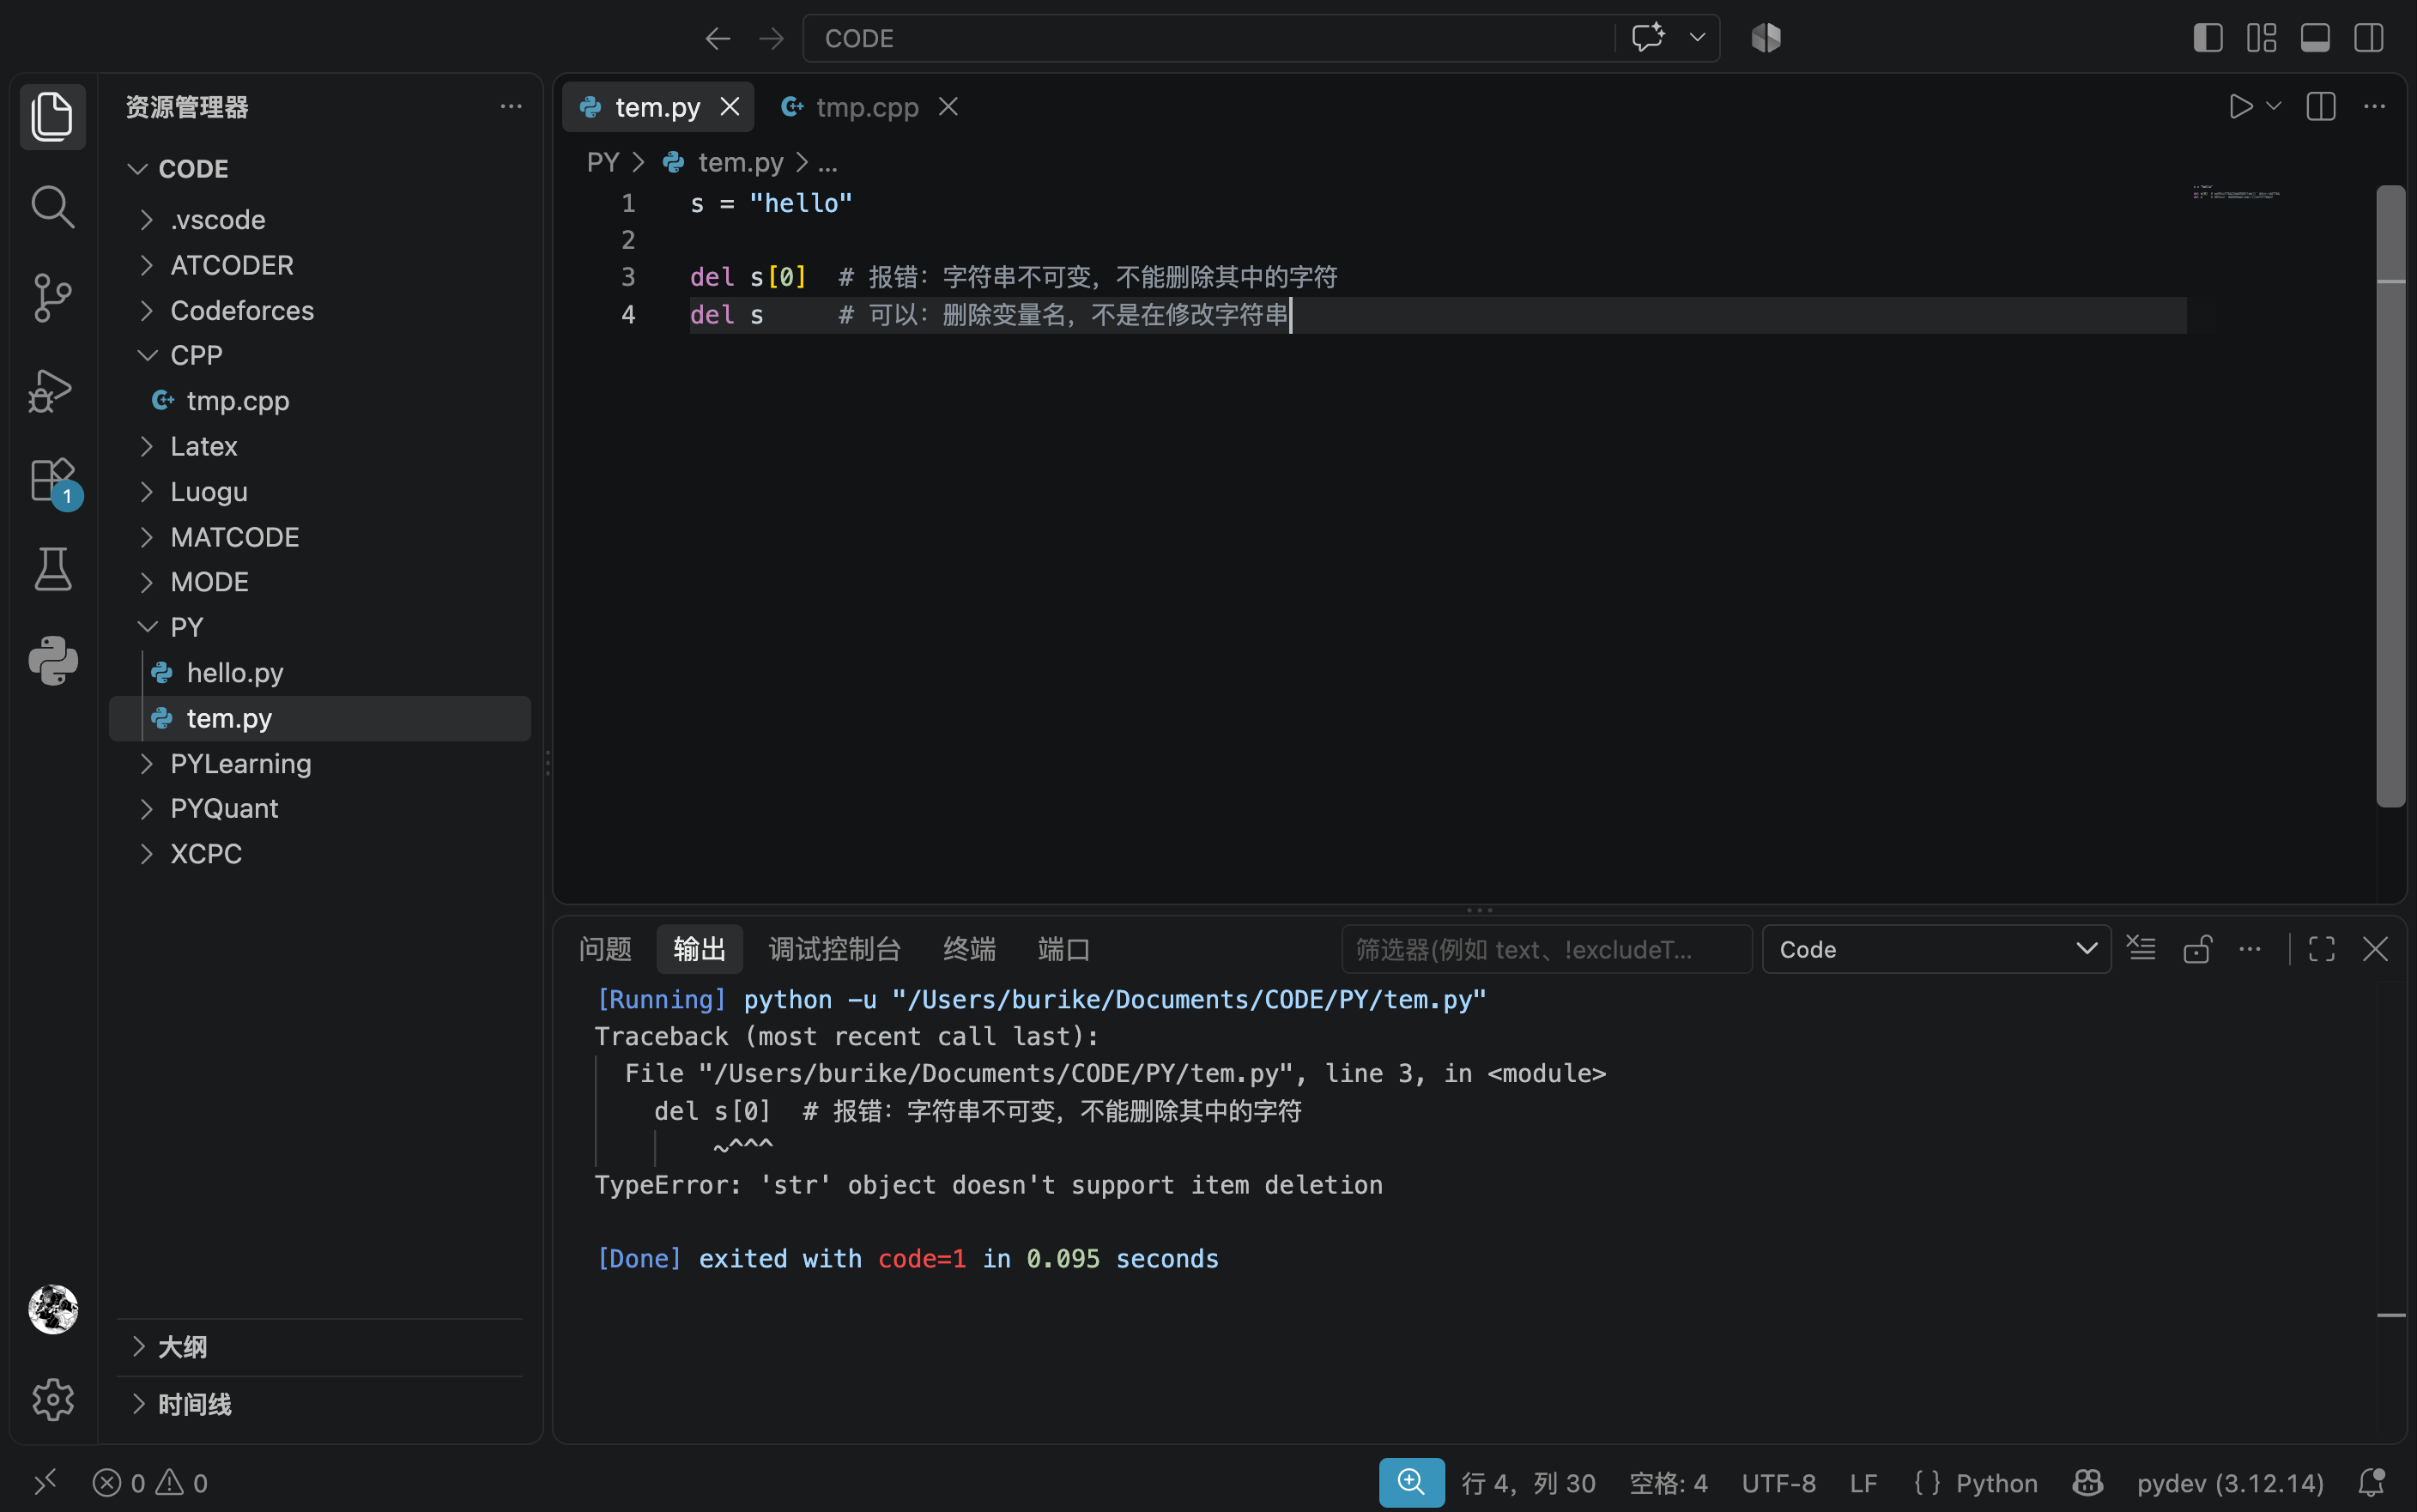
判断 del 的作用,关键看它后面写的是什么:del a 删除名称绑定,del a[i] 删除容器中的元素。 del 本身不会返回被删除的值。
数值运算
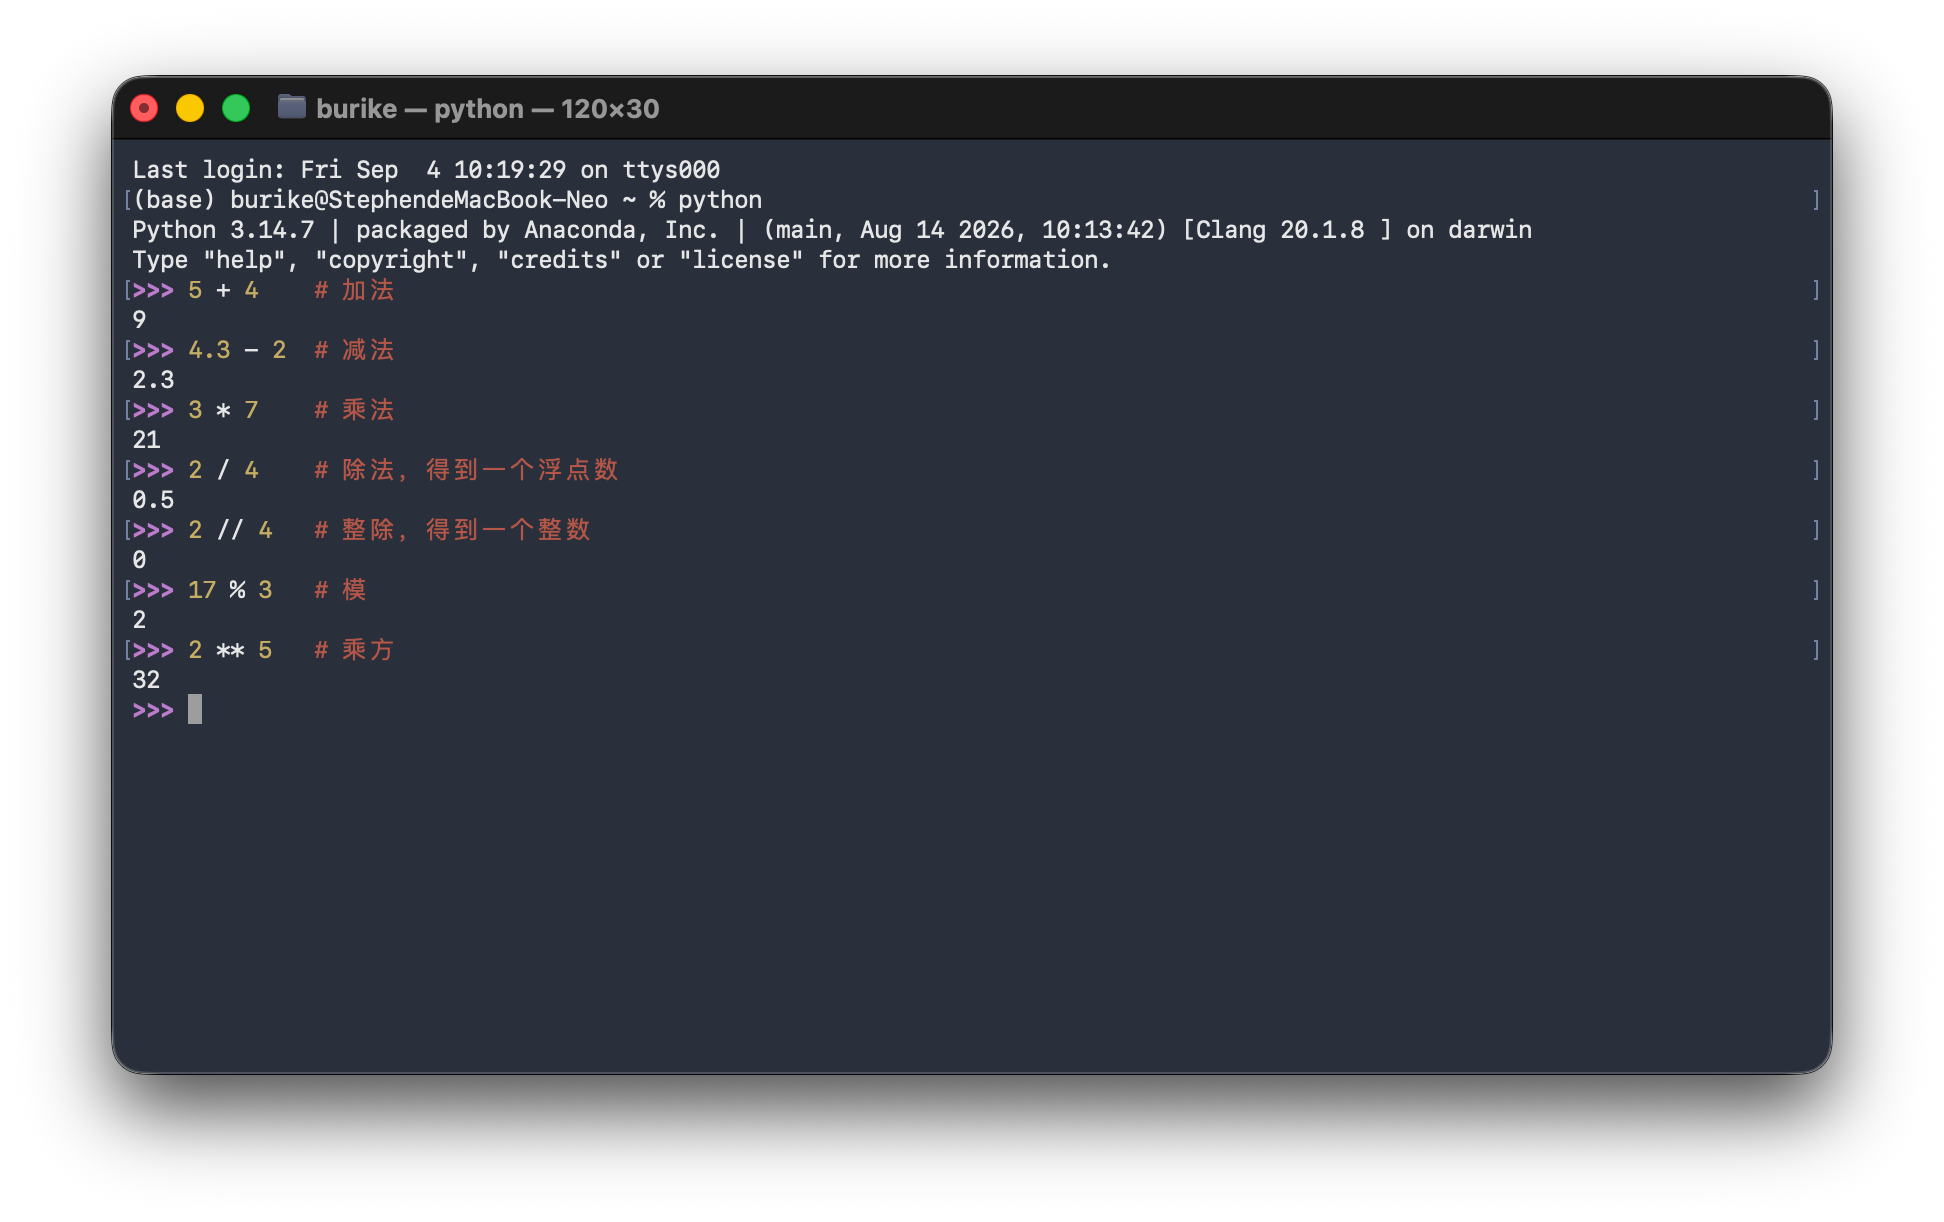
注意:
//返回一个整数,向下取整- 在混合计算时,Python 会统一把整型转换为浮点数
complex 复数:
Python 中的复数由实部和虚部组成,用 j 表示虚数单位(数学中通常写作 (i),满足 (i^2=-1))。
例如,数学中的 (3+4i),在 Python 中写成:
z = 3 + 4j
print(type(z))  # <class 'complex'>
注意:虚数单位前必须有数字,纯虚数 (i) 要写成 1j,不能直接写 j。
1. 创建复数、获取实部和虚部
z = complex(3, 4)  # 等价于 3 + 4j

print(z.real)     # 3.0:实部
print(z.imag)     # 4.0:虚部
                                    # 实部与虚部都是浮点型
2. 进行复数运算
a = 3 + 4j
b = 1 - 2j

print(a + b)  # (4+2j)
print(a - b)  # (2+6j)
print(a * b)  # (11-2j)
print(a / b)  # (-1+2j)

print(1j ** 2)  # (-1 + 0j),即 -1
复数可以做加、减、乘、除、乘方,但不支持用 <、> 比较大小。
3. 求模和共轭复数
对于 (z=3+4i),模是 ( $\sqrt{3^2+4^2}=5$ ),共轭复数是 (3-4i)。
z = 3 + 4j

print(abs(z))         # 5.0
print(z.conjugate())  # (3-4j)
4. 应用实例:求方程的复数解
例如求解 (x2 + 2x + 5 = 0),其判别式为负数,可以用处理复数的 cmath 模块:
import cmath        # 导入 cmath 库

a, b, c = 1, 2, 5
delta = b ** 2 - 4 * a * c

x1 = (-b + cmath.sqrt(delta)) / (2 * a)
x2 = (-b - cmath.sqrt(delta)) / (2 * a)

print(x1)  # (-1 + 2j)
print(x2) # (-1 - 2j)结合前面的数据类型分类,复数 complex 也是不可变类型。例如 z.real = 5 会报错;要改变实部,可以重新赋值为 z = complex(5, z.imag)。
注意:Python 3 中整数字面量不允许前导零(如
080),八进制数必须使用0o( 0 + 小写字母 o )前缀(如0o17),十六进制使用0x前缀(如0x69),二进制使用0b前缀
String(字符串)
Python 中的字符串用单引号 ' 或双引号 " 括起来,同时使用反斜杠 ** 转义特殊字符。关于转义。
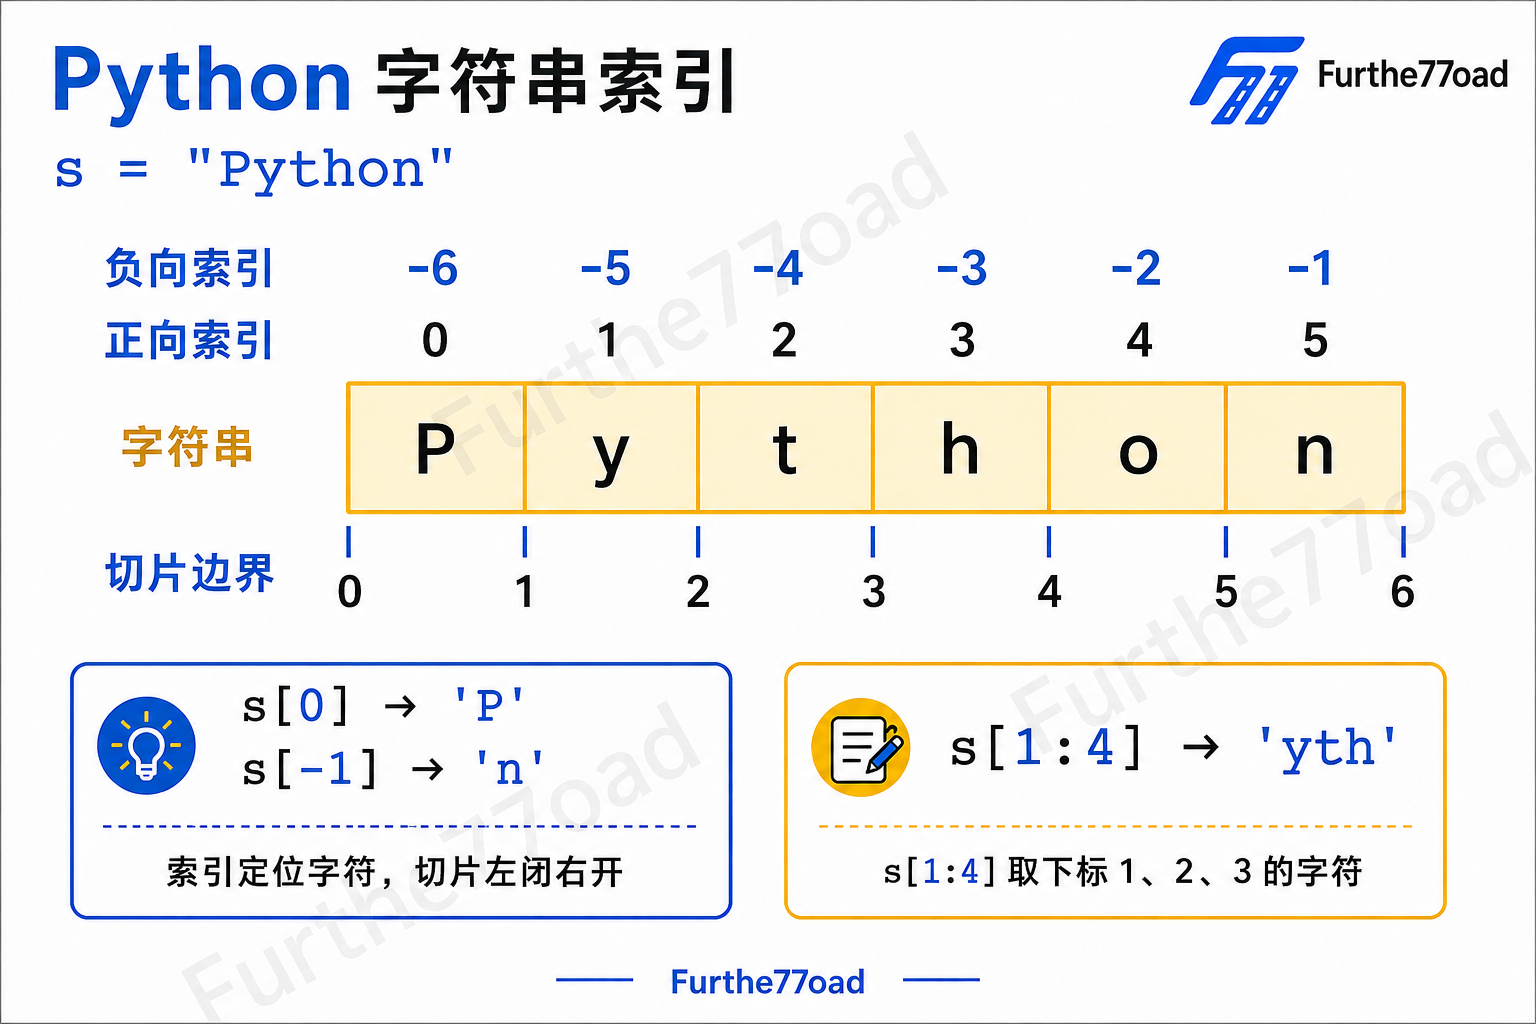
字符串截取的语法格式如下:
变量[头下标:尾下标]索引值以 0 为开始,-1 为末尾开始
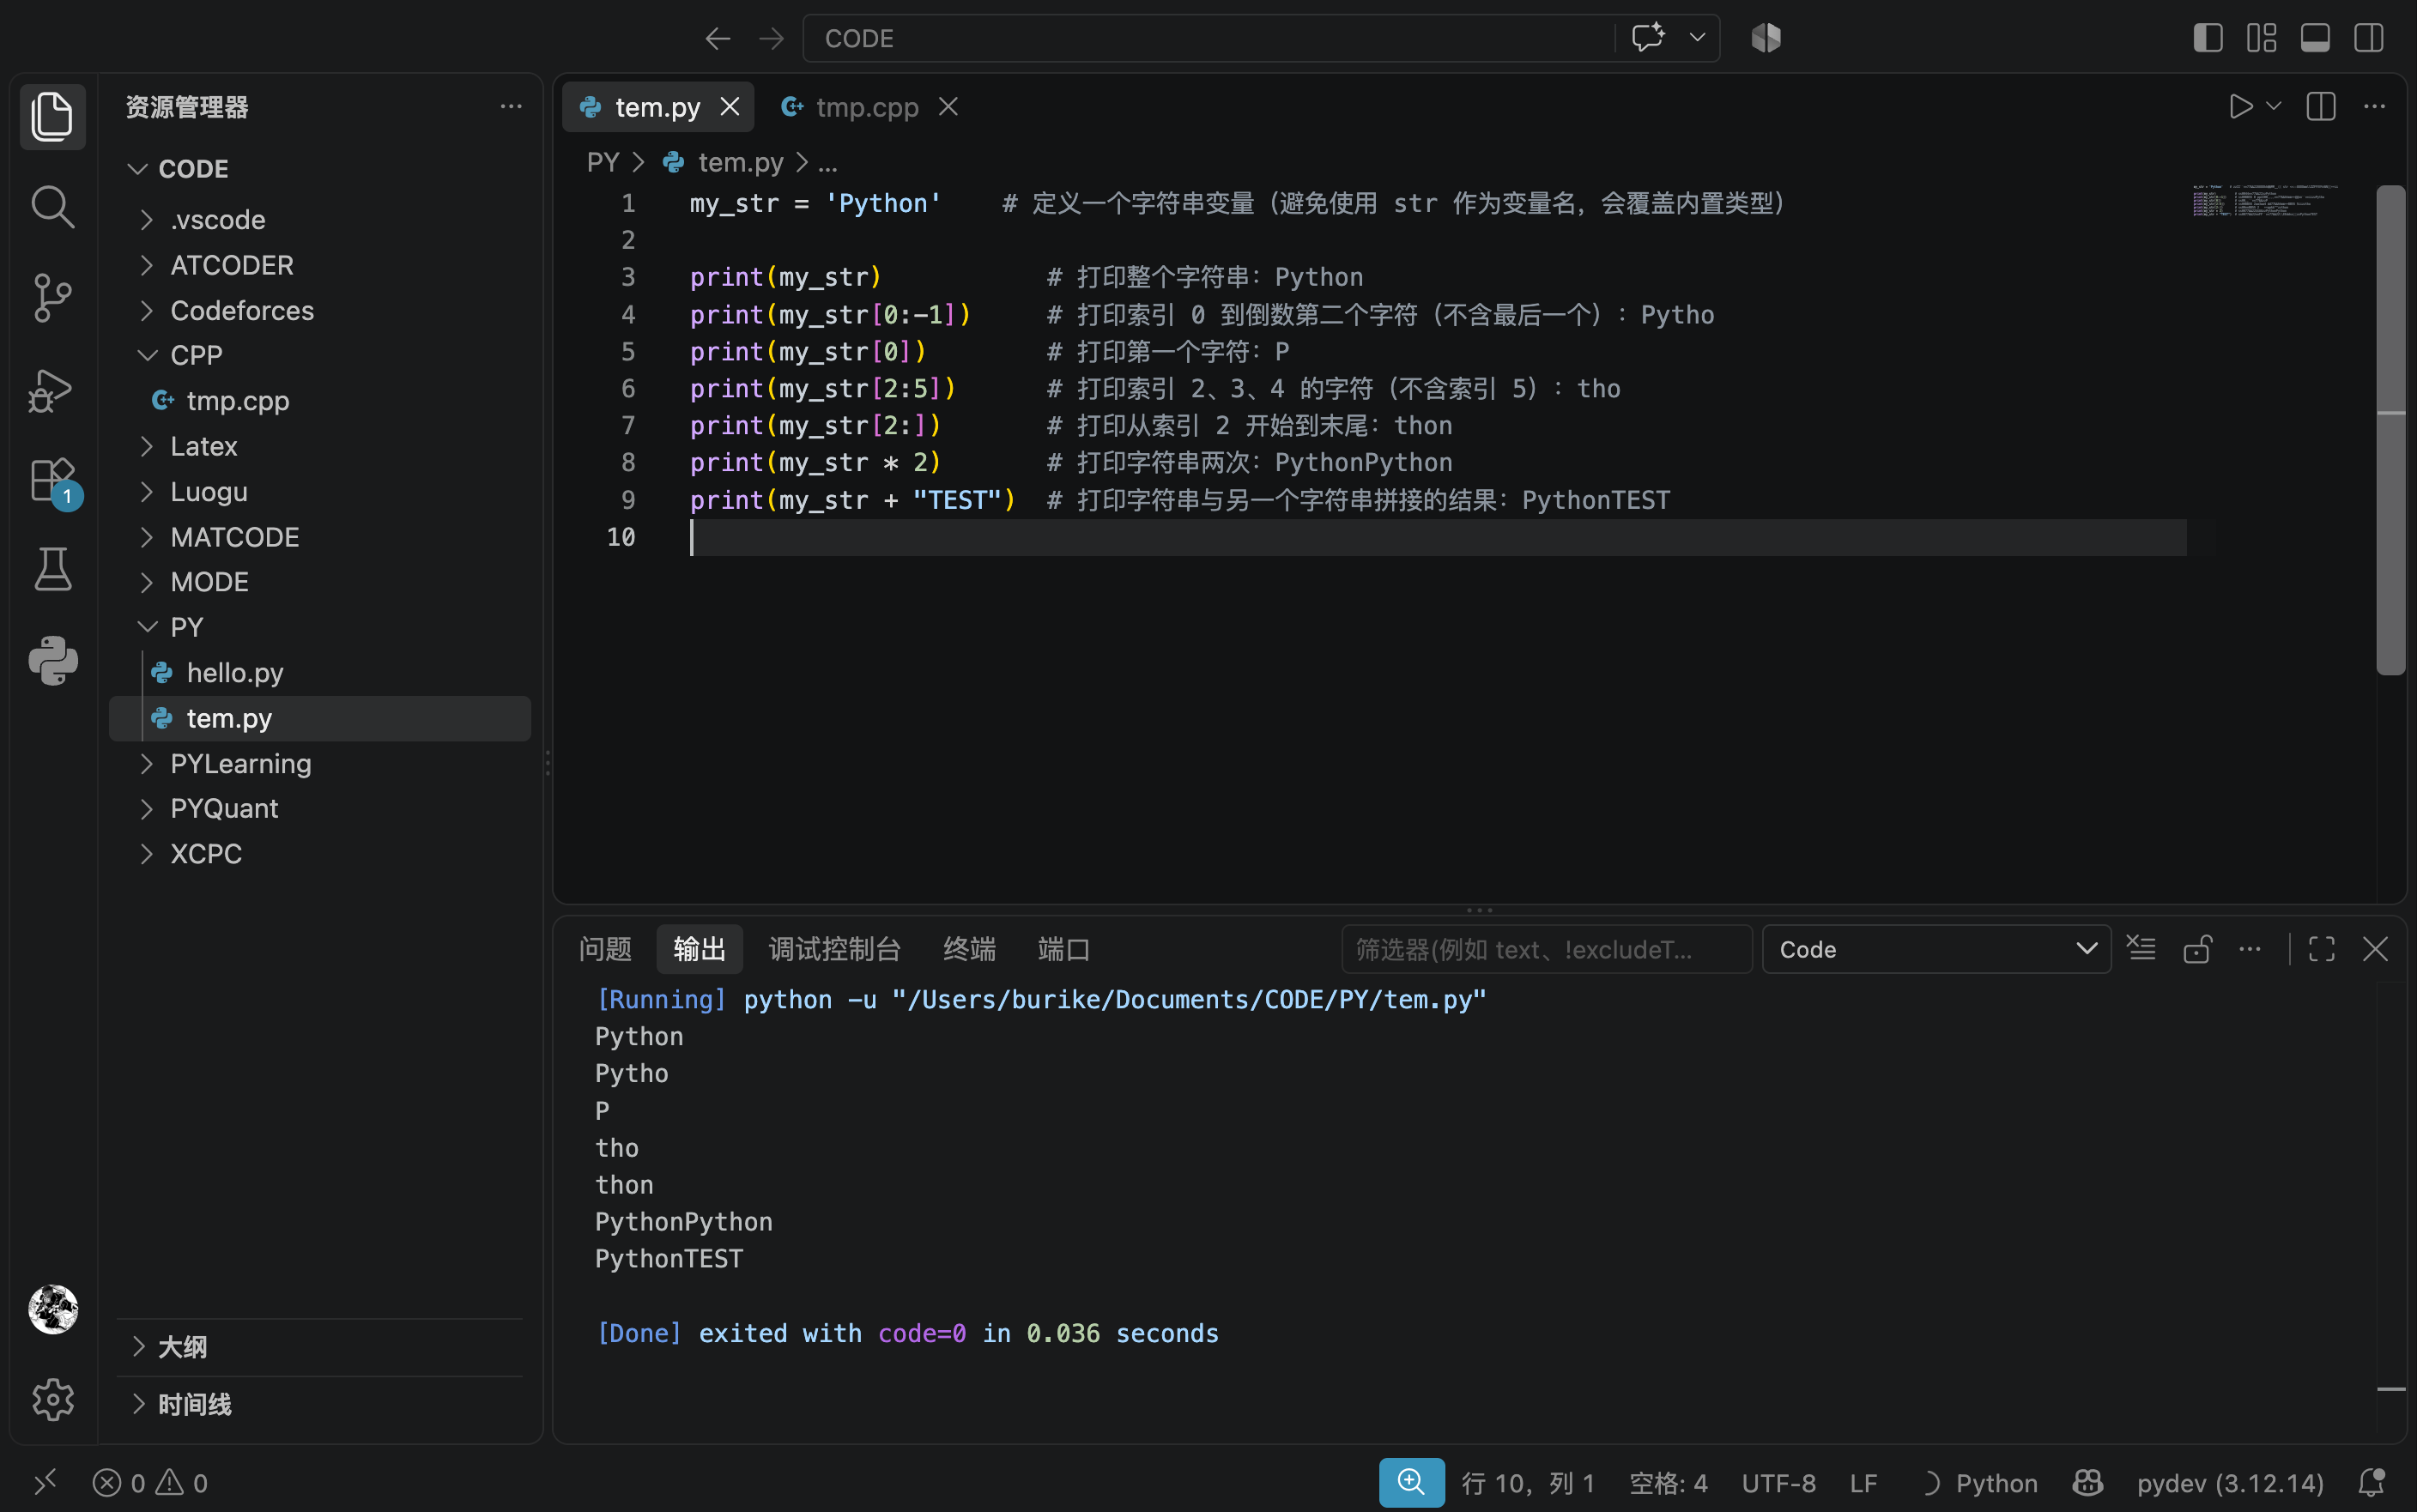
加号 + 是字符串的连接符,星号 ***** 表示复制当前字符串,与之结合的数字为复制的次数。实例如下:
更进一步的,字符串除了截取,还可以读入第三个参数,步长:
字符串[开始位置:结束位置:步长]例如:
s = "Python"- 基本截取
print(s[1:4]) # yth表示从索引 1 开始,截取到索引 4 之前。
切片遵循左闭右开规则:包含开始位置,不包含结束位置。
字符: P  y  t  h  o  n
索引: 0 1 2 3 4 5因此,s[1:4] 取索引 1、2、3 的字符。
- 省略开始或结束位置
print(s[:3])  # Pyt,从开头截取到索引 3 之前
print(s[2:])  # thon,从索引 2 截取到末尾
print(s[:]) # Python,截取整个字符串- 使用步长
步长表示每隔多少个位置取一个字符:
print(s[0:6:2]) # Pto它会依次取索引 0、2、4 的字符。
开始和结束位置都省略时,可以简写为:
print(s[::2])  # Pto,每隔一个字符取一次
print(s[::3])  # Ph,取索引 0、3
步长默认是 1:
s[1:4] # 等价于 s[1:4:1]- 负数步长
步长为负数时,表示从右向左截取:
print(s[::-1]) # nohtyP,字符串反转还可以指定范围:
print(s[4:1:-1]) # oht它从索引 4 开始向左取,依次访问 4、3、2,到索引 1 之前停止。
需要注意,步长不能是 0:
s[::0] # 报错:ValueError最常见的形式是:
s[start:stop]       # 按默认步长 1 截取
s[start:stop:step]  # 指定步长
s[::-1]             # 反转字符串
bool(布尔类型)
布尔类型即 True 或 False。在 Python 中,True 和 False 都是关键字,表示布尔值。
布尔类型可以用来控制程序的流程,比如判断某个条件是否成立,或者在某个条件满足时执行某段代码。
布尔类型特点:
- 布尔类型只有两个值:True 和 False。
- bool 是 int 的子类,因此布尔值可以被看作整数来使用,其中 True 等价于 1,False 等价于 0。
- 布尔类型可以和其他数据类型进行比较,比如数字、字符串等。在比较时,Python 会将 True 视为 1,False 视为 0。
- 布尔类型可以和逻辑运算符一起使用,包括
and、or和not,用来组合多个布尔表达式。 - 布尔类型也可以被转换成其他数据类型,比如整数、浮点数和字符串。在转换时,True 会被转换成 1,False 会被转换成 0。
- 可以使用
bool()函数将其他类型的值转换为布尔值。以下值转换为布尔值时为False:None、False、零(0、0.0、0j)、空序列(如''、()、[])和空映射(如{})。其他所有值转换为布尔值时均为True。
List(列表)
列表是 Python 中使用最频繁的数据结构,写在方括号 [] 之间,用逗号 , 分隔开元素,列表类似于高级的数组 a[] ,可以理解为功能更灵活的数组。
nums = [10, 20, 30, 40]

print(nums[0])   # 10
print(nums[-1])  # 40
它和传统数组一样:
- 可以按顺序保存多个元素
- 可以通过索引访问元素
- 可以修改、添加和删除元素
nums[0] = 100       # 修改
nums.append(50)     # 末尾添加
del nums[1]         # 删除
但 Python 列表比传统数组更灵活,可以存放不同类型的数据:
data = [10, "Python", True, 3.14]不过实际编程时,通常仍建议一个列表存放意义相同的数据:
scores = [85, 92, 76, 100]列表也可以嵌套,形成类似二维数组的结构:
matrix = [
    [1, 2, 3],
    [4, 5, 6]
]
print(matrix[1][2]) # 6主要区别是:传统数组通常要求元素类型相同,内存排列紧密,更适合大量数值计算;Python list 保存的是一组对象的引用,类型可以不同,使用更灵活。如果需要高效进行大量数值运算,通常使用 NumPy 数组(在 NumPy 库里的一种容器)。
和字符串一样,列表同样可以被索引和截取,列表被截取后返回一个包含所需元素的新列表。列表截取的语法格式:变量[头下标:尾下标]
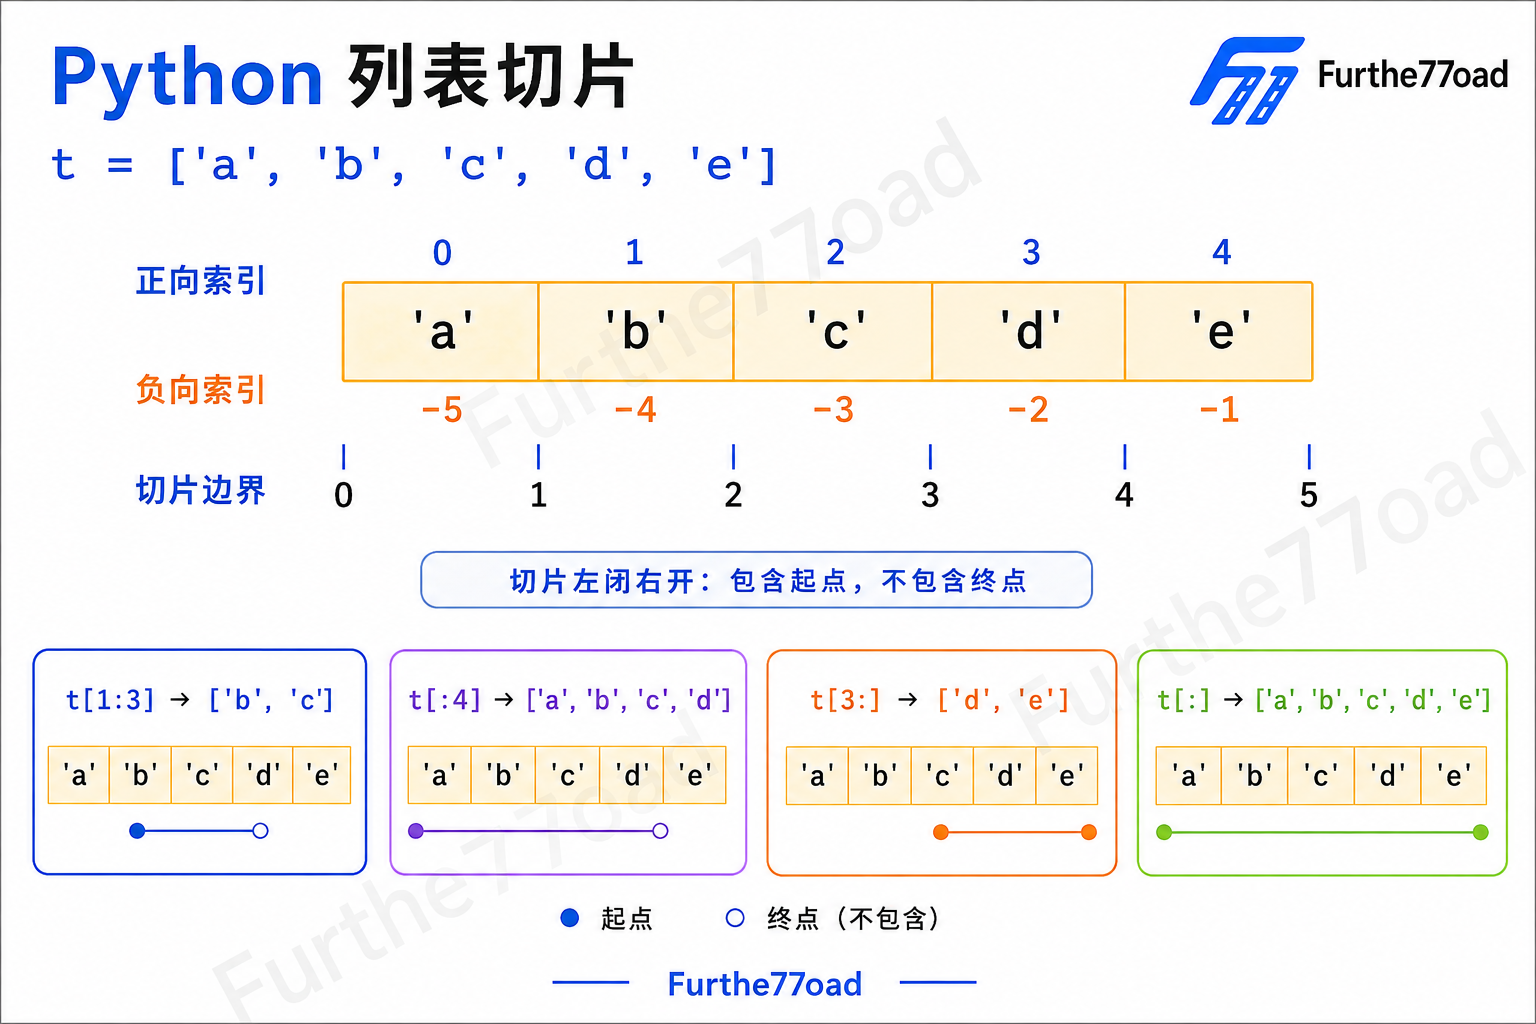
类似字符串,加号 + 是列表连接运算符,星号 * 是重复操作运算符。
不类似字符串,列表中的元素是可以改变的。
List 内置了有很多方法,例如 append() 、pop() 等,后面会讲到。
同样的, Python 列表也可以设置步长截取,语法和字符串部分相同。
Tuple(元组)
元组(tuple)与列表类似,不同之处在于元组的元素不能修改,元组是不可修改的容器。元组写在小括号 () 里,元素之间用逗号隔开。
元组中的元素类型也可以不相同:
my_tuple = ('Furthe77oad', 3.14, 1145141919810) # 避免使用 tuple 作为变量名同样,元组也有 + 和 * 的语法,也有切片截取步长。
元组与字符串类似,可以被索引且下标从 0 开始,-1 为从末尾开始的位置,也可以进行截取。其实,可以把字符串看作一种特殊的元组。
虽然元组的元素不可改变,但它可以包含可变的对象,比如 list 列表。
a = ([10, 20], 30)元组不能直接替换内部的元素,因为它是不可修改的容器:
a[0] = [100, 200] # Error但是元组包含的可变元素是可以改变的:
a[0].append(40)
print(a)  # ([10, 20, 40], 30)
另外,有一些额外的语法规则,构造包含 0 个或者 1 个元素的元组时:
tup_1 = ()          # 空元组
tup_2 = (1, )       # 一个元素的元组
如果要创建一个元素的元组,一定要在元素后添加一个逗号,以区分它是元组而不是普通的值,因为没有逗号的话,Python 会将括号解释为数学运算中的括号:
t = (1) # type(t) : <classType: int>Set (集合)
Python 中的集合写作 set,是一种用于保存不重复元素的可变容器。它很像数学中的集合,特别适合去重、判断元素是否存在,以及进行交集、并集等运算。
- 创建集合
使用大括号创建:
numbers = {10, 20, 30}
print(numbers)              # {10, 20, 30}
print(type(numbers))  # <class 'set'>
也可以使用 set():
numbers = set([10, 20, 30])
print(numbers)  # {10, 20, 30}
创建空集合时必须使用 set():
a = set()  # 空集合
b = {}     # 空字典,不是集合
print(type(a))  # <class 'set'>
print(type(b)) # <class 'dict'>- 集合中的元素不重复
集合会自动去掉重复元素:
numbers = {10, 20, 10, 30, 20}
print(numbers)  # {10, 20, 30}
因此可以使用集合对列表去重:
numbers = [1, 2, 2, 3, 3, 3]

result = set(numbers) # 等价于 set([1, 2, 2, 3, 3, 3])

# 这里本质与 set([1, 2, 3], [2, 3, 3]) 有非常大的区别,后面会说到,集合中的元素必须是可哈希的(hashable)

print(result)  # {1, 2, 3}
如果还需要列表:
result = list(set(numbers))     # 这里把 set 转换为 list
print(result) # [1, 2, 3]这种方法不能保证保留原来的元素顺序。如果要在去重时保留列表顺序,可以写:
numbers = [3, 1, 3, 2, 1]
result = list(dict.fromkeys(numbers))
# 当然这里没有用到任何和 set 有关的东西,这里利用是“字典”的特性,后面会讲到
print(result) # [3, 1, 2]- 集合没有索引和切片
集合中的元素没有固定的位置,因此不能用索引访问:
letters = {"a", "b", "c"}
print(letters[0])  # 报错
集合也不支持切片:
letters[0:2] # 报错打印集合时,元素显示顺序也可能和写入顺序不同:
letters = {"a", "b", "c"}
print(letters)  # 显示顺序不应作为程序依据
需要通过遍历读取元素:
for letter in letters:
    print(letter)       # 你也不应该依赖遍历读取到的顺序
需要在读取时编号:
for i, number in enumerate(numbers):
    print(i, number)        # 这里的 i 只是遍历时产生的编号
# 如果期望从 1 开始遍历的话,可以 enumerate(numbers, start=1)
# 或者可以写 enumerate(numbers, 1)- 增加元素
使用 add() 增加一个元素:
numbers = {10, 20}
numbers.add(30)
print(numbers)  # {10, 20, 30}
如果元素已经存在,集合不会重复添加:
numbers.add(20)
print(numbers)  # 仍然只有 10、20、30
使用 update() 一次加入多个元素:
numbers = {10, 20}
numbers.update([20, 30, 40])
print(numbers)  # {10, 20, 30, 40}
update() 可以接收列表、元组、集合等可迭代对象。
- 删除元素
remove() 删除指定元素:
numbers = {10, 20, 30}
numbers.remove(20)
print(numbers) # {10, 30}如果元素不存在,remove() 会报错:
numbers.remove(100) # KeyErrordiscard() 也能删除元素,但元素不存在时不会报错:
numbers = {10, 20, 30}
numbers.discard(20)
numbers.discard(100)  # 不报错
print(numbers)  # {10, 30}
不确定元素是否存在时,通常使用 discard() 更方便。
pop() 删除并返回集合中的某个元素:
numbers = {10, 20, 30}
value = numbers.pop()
print(value)        # 这里也不确定会 pop 哪一个
print(numbers)
集合没有固定顺序,因此不要把 pop() 理解为删除“最后一个元素”。
clear() 清空集合:
numbers = {10, 20, 30}
numbers.clear()
print(numbers) # 输出 set()- 判断元素是否存在
使用 in:
numbers = {10, 20, 30}

print(20 in numbers)      # True
print(100 in numbers)     # False
print(100 not in numbers) # True
集合判断元素是否存在通常很快,因此适合处理大量查询。
例如检查用户名是否已被占用:
registered_names = {"alice", "bob", "tom"}
name = "bob"
if name in registered_names:
    print("用户名已存在")
else:
print("用户名可以使用")- 集合运算
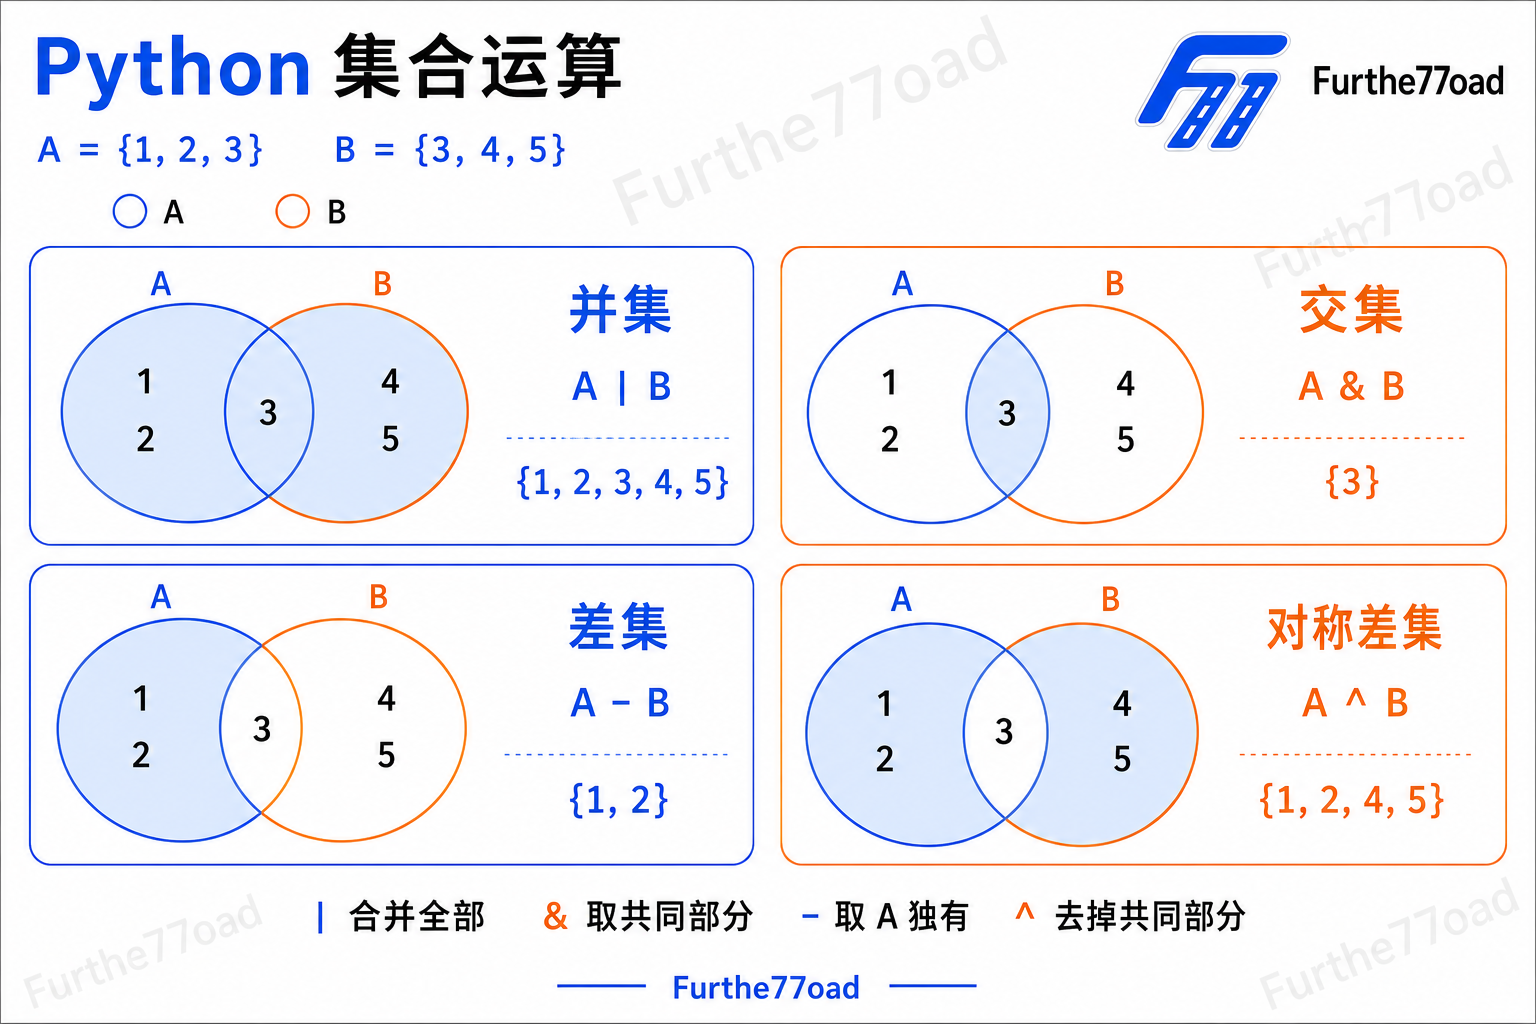
假设有两个集合:
a = {1, 2, 3}
b = {3, 4, 5}
并集:合并所有元素
print(a | b) # {1, 2, 3, 4, 5}也可以使用:
print(a.union(b))交集:两个集合共同拥有的元素
print(a & b) # {3}也可以使用:
print(a.intersection(b))差集:前一个集合有,后一个集合没有的元素
print(a - b)    # {1, 2}
print(b - a)    # {4, 5}
a - b 和 b - a 的结果通常不同。
对称差集:只在其中一个集合中的元素
print(a ^ b) # {1, 2, 4, 5}也就是排除两个集合共有的元素。
这些运算可以概括为:
| 运算 | 写法 | 含义 |
|---|---|---|
| 并集 | `a | b` |
| 交集 | a & b |
两个集合共有的元素 |
| 差集 | a - b |
a 有但 b 没有 |
| 对称差集 | a ^ b |
只出现在一个集合中 |
- 子集和超集
a = {1, 2}
b = {1, 2, 3}
判断 a 是否是 b 的子集:
print(a <= b)  # True
print(a.issubset(b))  # True
判断 b 是否是 a 的超集:
print(b >= a)  # True
print(b.issuperset(a)) # True判断两个集合是否没有共同元素:
a = {1, 2}
b = {3, 4}
print(a.isdisjoint(b)) # True- 集合中的元素必须是可哈希对象
集合中的元素必须是不能随意变化的可哈希对象。通常可以放入:
values = {
    10,          # 整数
    3.14,        # 浮点数
    "Python",    # 字符串
    (1, 2)       # 元组
}
列表、字典和普通集合不能直接放入集合:
values = {[1, 2], [3, 4]} # 报错:列表不可哈希原因是列表会发生变化,不适合作为集合中用于识别元素的值。在这里关于哈希你可能想了解的
- 集合本身是可变容器
普通集合可以增加和删除元素:
a = {1, 2}
a.add(3)
a.remove(1)
print(a)  # {2, 3}
因此 set 属于可变容器。
Python 还提供了不可变集合 frozenset:
a = frozenset({1, 2, 3})
a.add(4)  # 报错
由于 frozenset 不可变,因此它可以作为字典的键,也可以放入另一个集合:
groups = {
    frozenset({1, 2}),
    frozenset({3, 4})
}- 集合推导式
集合也支持推导式:
squares = {x ** 2 for x in range(1, 6)}
print(squares)
# 包含 1、4、9、16、25
可以添加筛选条件:
even_squares = {x ** 2 for x in range(1, 10) if x % 2 == 0}
print(even_squares)
# 包含 4、16、36、64
Dictionary (字典)
Python 中的字典写作 dict,它使用“键—值”的形式保存数据。类似于 C++ 的 map。可以把字典理解成现实中的通讯录:
姓名 → 电话号码在 Python 中则写成:
phone_book = {
    "小明": "13800000001",
    "小红": "13800000002"
}
其中:
"小明"是键,英文叫key。"13800000001"是值,英文叫value。- 键和值合在一起称为键值对。
- 创建字典
使用大括号创建:
student = {
    "name": "小明",
    "age": 18,
    "score": 95
}
也可以使用 dict():
student = dict(name = "小明", age = 18, score = 95)创建空字典:
student = {}
print(type(student))  # <class 'dict'>
注意:
{}     # 空字典
set() # 空集合- 根据键读取值
字典没有数字位置索引(这里是数字位置索引,不是数字索引),而是使用键读取值:
student = {
    "name": "小明",
    "age": 18,
    "score": 95
}

print(student["name"])   # 小明
print(student["age"])    # 18
print(student["score"])  # 95
这里的 "name" 就像数据的名字或标签。
如果访问不存在的键,会产生 KeyError:
print(student["gender"]) # KeyError可以使用 get() 安全读取:
print(student.get("gender")) # 在为指定时默认返回 None也可以提供默认值:
print(student.get("gender", "未知")) # 指定默认值后,返回指定的默认值两种读取方式的区别是:
student["gender"]          # 键不存在时产生 KeyError
student.get("gender")      # 键不存在时返回 None
student.get("gender", "") # 键不存在时返回指定默认值- 增加键值对
给一个不存在的键赋值,就是增加数据:
student = {
    "name": "小明",
    "age": 18
}
student["score"] = 95
print(student)
# {'name': '小明', 'age': 18, 'score': 95}- 修改字典
给已经存在的键赋值,就是修改对应的值:
student["age"] = 19
print(student)
# {'name': '小明', 'age': 19, 'score': 95}
因此,同一种写法可能表示增加,也可能表示修改:
dictionary[key] = value关键在于这个键之前是否存在。
- 字典的键不能重复
student = {
    "name": "小明",
    "name": "小红"
}
print(student)
# {'name': '小红'}
同一个键出现多次时,后面的值会覆盖前面的值。
这也是下面这段代码能够去重的原因:(可以联系上面在 set 里的一段代码)
numbers = [3, 1, 3, 2, 1]
d = dict.fromkeys(numbers)
print(d)
# {3: None, 1: None, 2: None}
重复的数字无法成为重复的字典键。
- 删除键值对
使用 del
student = {
    "name": "小明",
    "age": 18,
    "score": 95
}
del student["score"]
print(student)
# {'name': '小明', 'age': 18}如果键不存在,del 会产生 KeyError。
使用 pop()
pop() 删除指定键,并返回相应的值:
student = {
    "name": "小明",
    "age": 18
}
age = student.pop("age")
print(age)      # 18
print(student)  # {'name': '小明'}
可以提供默认值,避免键不存在时报错:
gender = student.pop("gender", "未知")
print(gender)  # 未知
使用 clear()
清空所有键值对:
student.clear()
print(student) # {}- 判断键是否存在
使用 in:
student = {
    "name": "小明",
    "age": 18
}
print("name" in student)       # True
print("score" in student)      # False
print("score" not in student)  # True
in 默认判断的是键,不是值。
如果想判断某个值是否存在,可以写:
print("小明" in student.values()) # True- 遍历字典
假设有:
student = {
    "name": "小明",
    "age": 18,
    "score": 95
}
遍历所有键
for key in student:
    print(key)
也可以明确写成:
for key in student.keys():
    print(key)
遍历所有值
for value in student.values():
    print(value)
同时遍历键和值
for key, value in student.items():
print(key, value)这里的:key, value 会分别接收每一个键值对的键和值。
- 常用方法
对于:
student = {
    "name": "小明",
    "age": 18
}| 方法 | 作用 |
|---|---|
student.keys() |
获得所有键 |
student.values() |
获得所有值 |
student.items() |
获得所有键值对 |
student.get(key) |
安全读取指定键的值 |
student.pop(key) |
删除并返回指定键的值 |
student.update(...) |
添加或更新多个键值对 |
student.clear() |
清空字典 |
例如使用 update():
student.update({
    "age": 19,
    "score": 95
})
print(student)
# {'name': '小明', 'age': 19, 'score': 95}
age 已经存在,所以被修改;score 不存在,所以被增加。
- 字典的值可以是任意类型
student = {
    "name": "小明",
    "age": 18,
    "passed": True,
    "scores": [90, 95, 88]
}
可以读取列表中的元素:
print(student["scores"])     # [90, 95, 88]
print(student["scores"][0])  # 90
字典的值还可以是另一个字典:
student = {
    "name": "小明",
    "contact": {
        "phone": "13800000001",
        "city": "上海"
    }
}

print(student["contact"]["city"])  # 上海
读取过程是:
student
   ↓ 读取 "contact"
内部字典
   ↓ 读取 "city"
"上海"- 键有什么要求
字典的键必须是可哈希的对象。常见的可用类型有:
d = {
    "name": "小明",  # 字符串作为键
    1: "第一项",      # 整数作为键
    (10, 20): "坐标"  # 元组作为键
}
列表、字典和集合不能作为字典的键:
d = {
    [1, 2]: "内容"
}
这会报错,因为列表是可变对象。
字典的值没有这个限制:
d = {
    "numbers": [1, 2, 3],
    "settings": {"color": "blue"}
}- 字典本身是可变容器
字典创建后可以增加、修改和删除键值对:
student = {"name": "小明"}

student["age"] = 18       # 增加
student["name"] = "小红"  # 修改
del student["age"]        # 删除
所以 dict 和 list、set 一样,都属于可变容器。
它们的主要区别是:
| 类型 | 保存方式 | 是否重复 | 是否支持位置索引 |
|---|---|---|---|
list |
一组有顺序的元素 | 可以重复 | 支持 |
set |
一组不重复的元素 | 不能重复 | 不支持 |
dict |
一组键值对 | 键不能重复 | 使用键读取 |
- 字典推导式
{x: x**2 for x in (2, 4, 6)}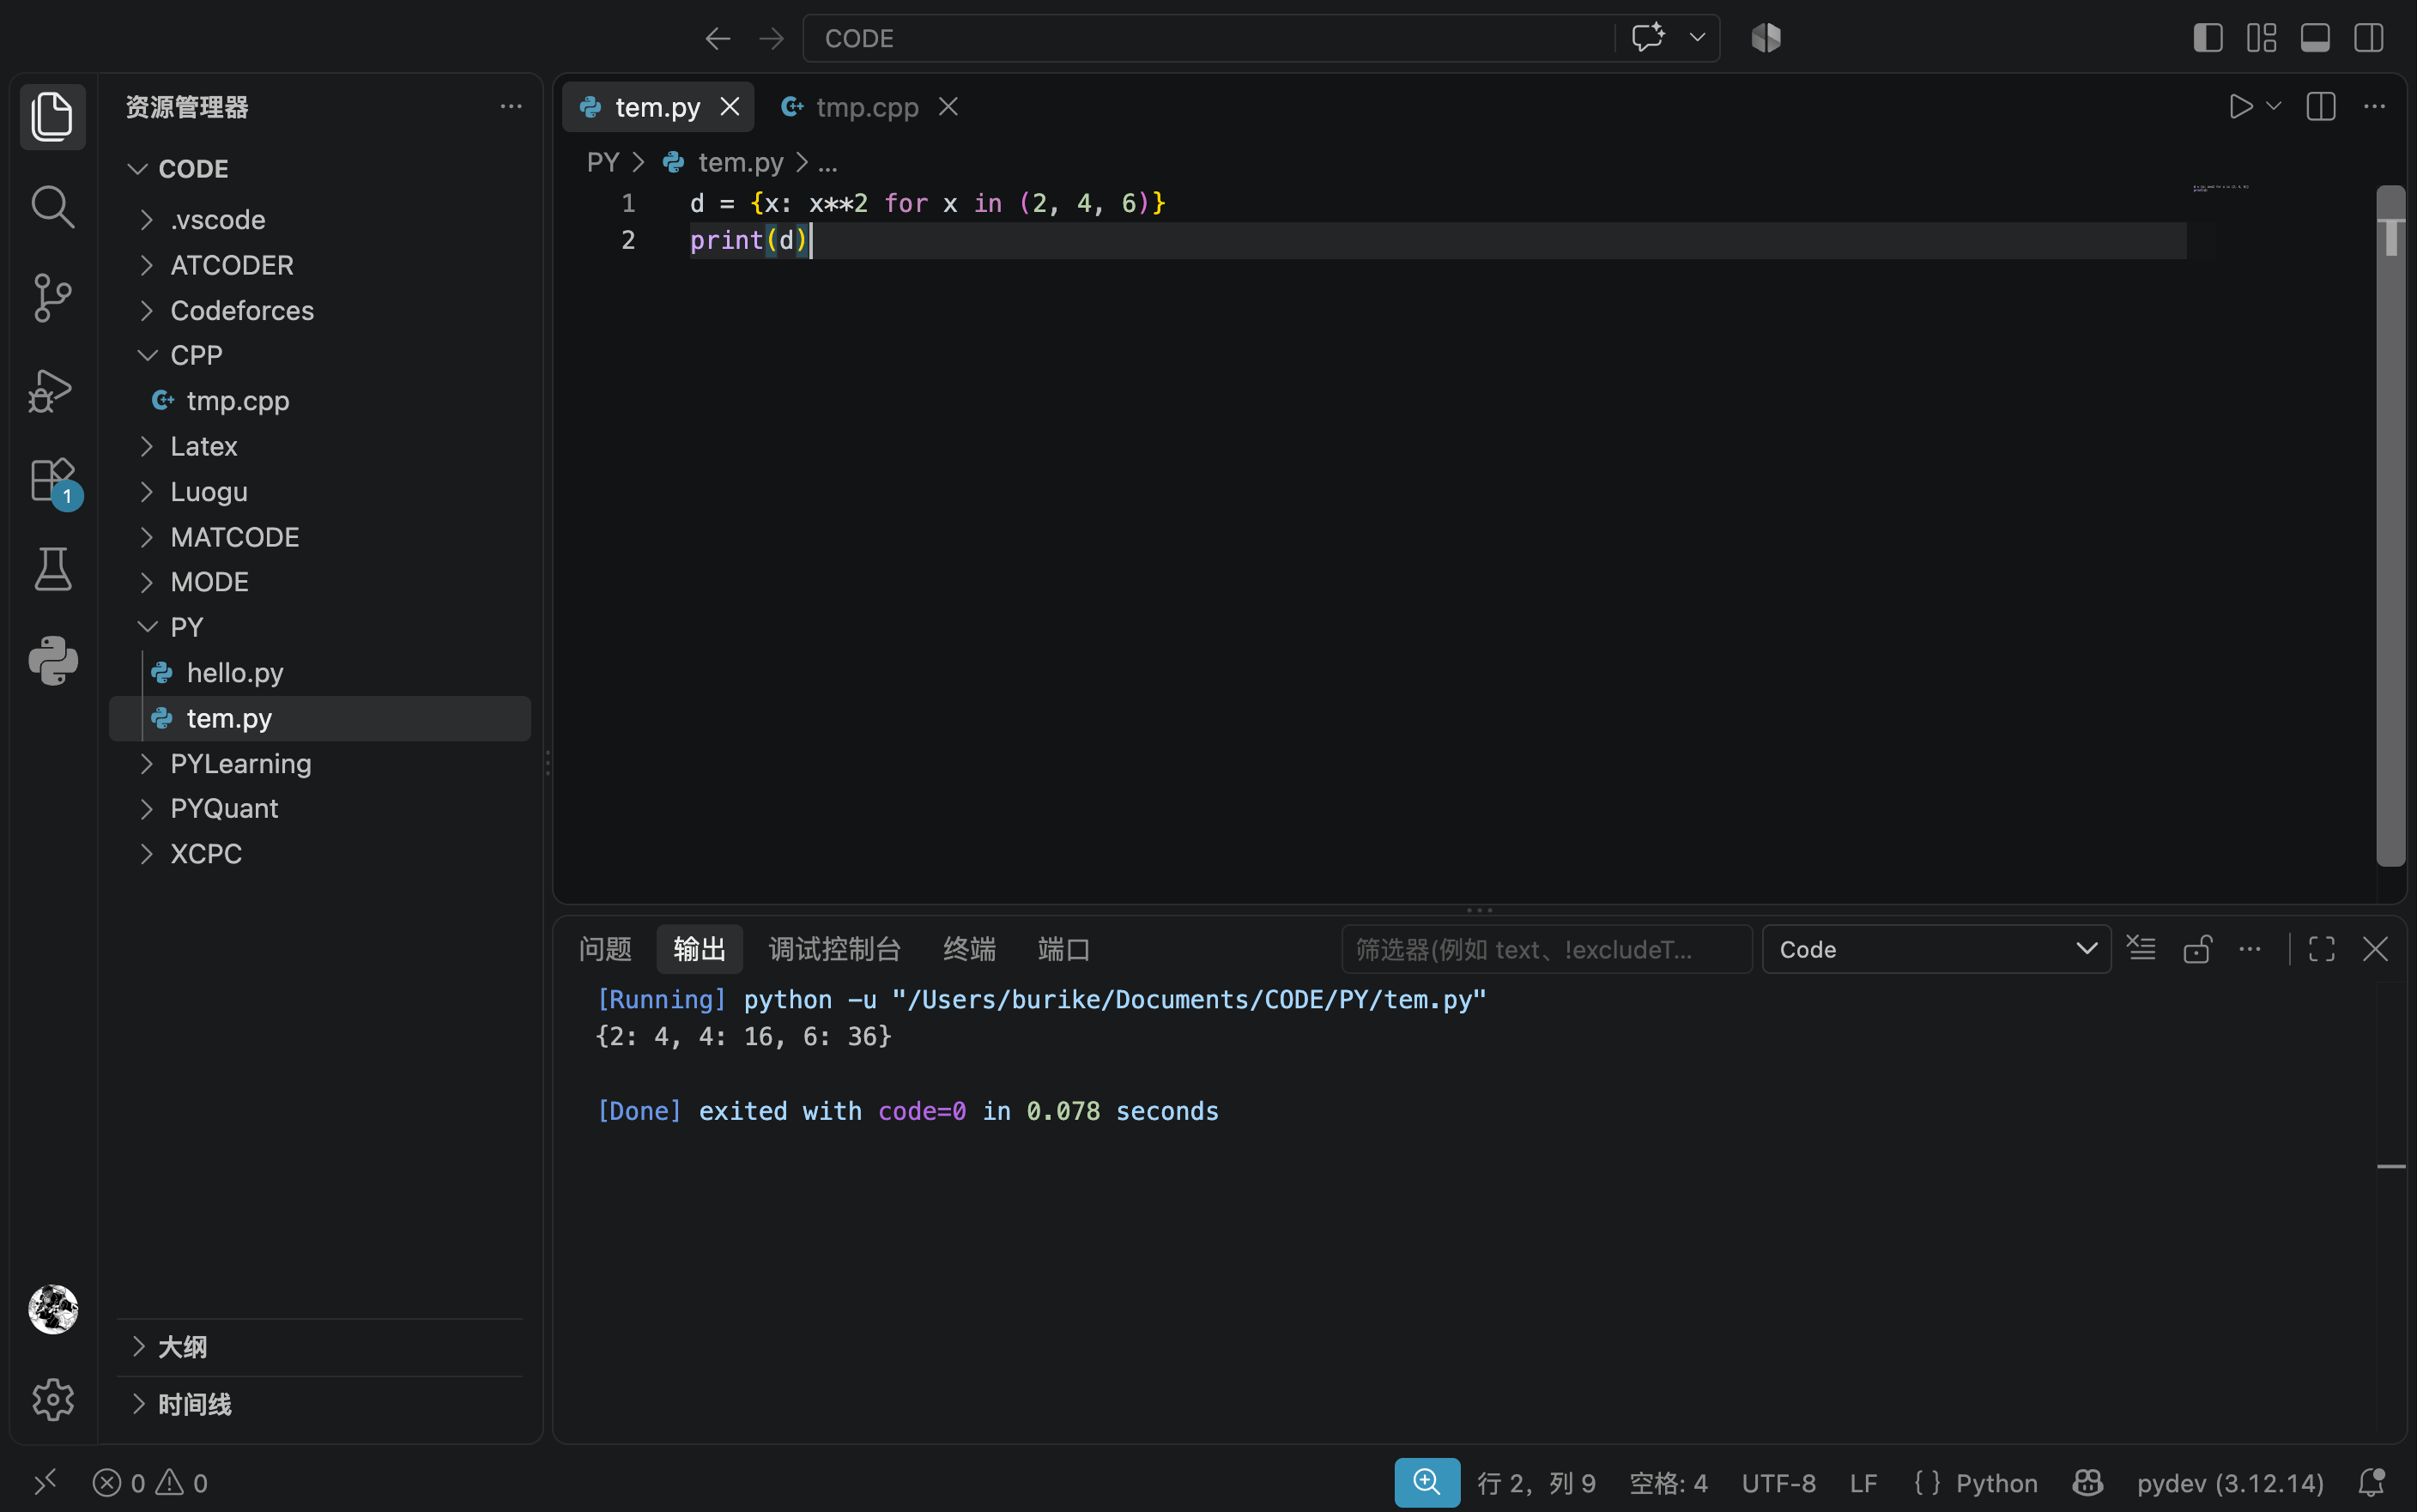
使用的是字典推导式,更多推导式内容可以参考:Python推导式
bytes 类型
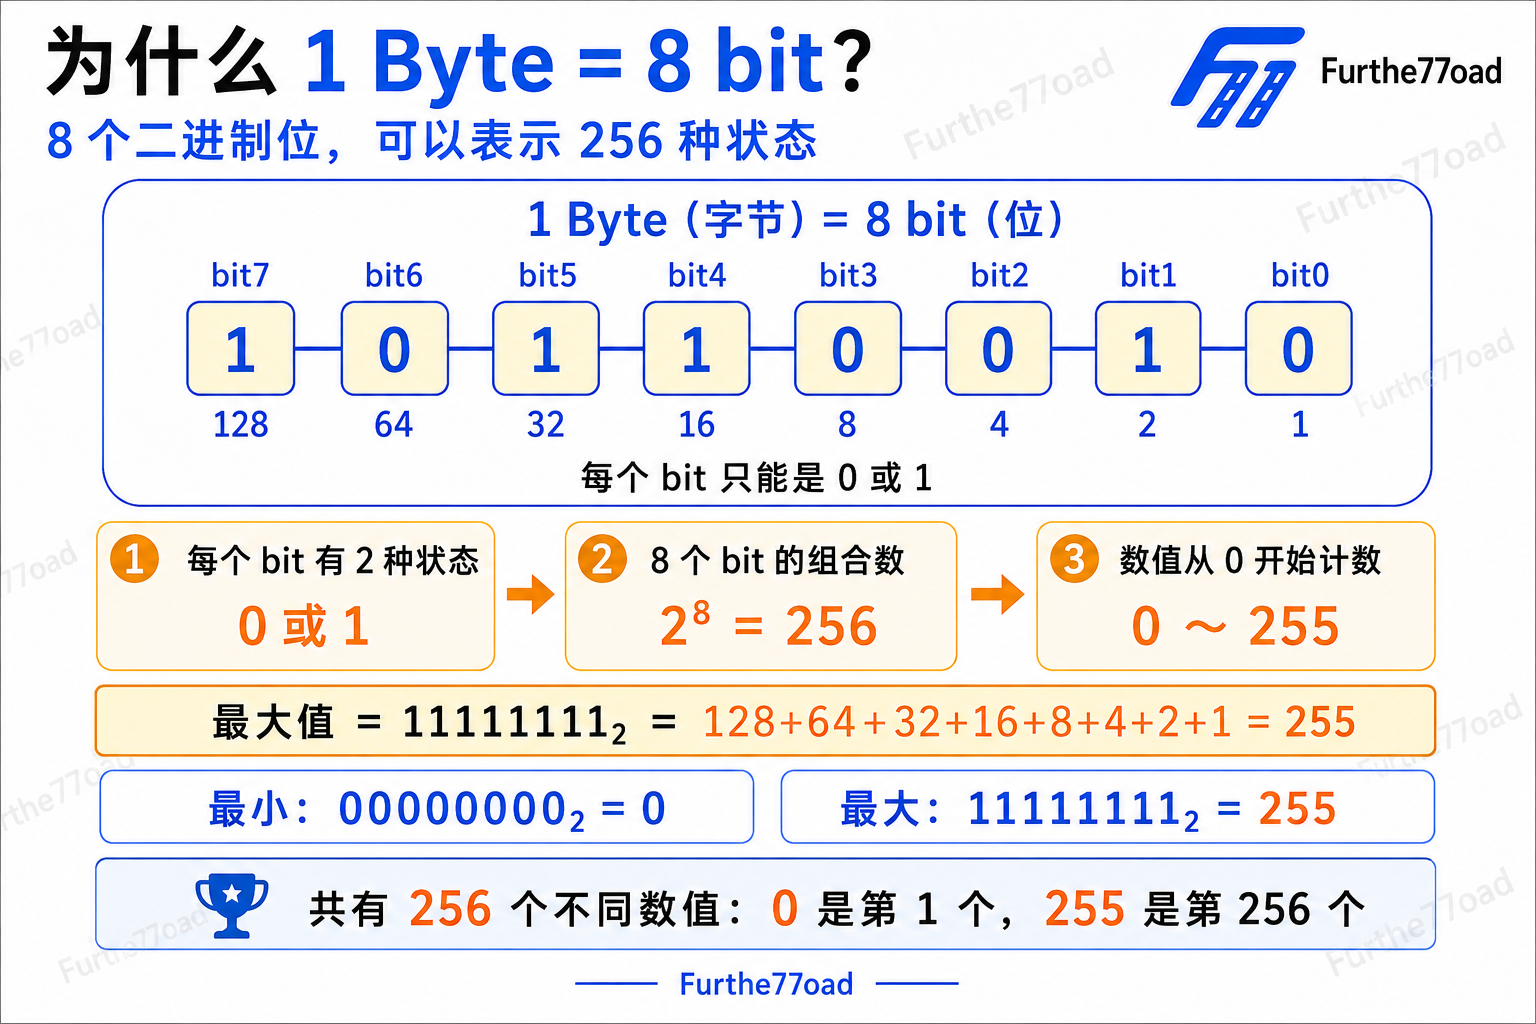
在 Python 中,bytes 类型表示的是不可变的二进制序列(byte sequence),与字符串类型不同的是,bytes 类型中的元素是整数值(0 到 255 之间的整数),而不是 Unicode 字符。
为什么是 0~255?
因为 bytes 是字节,一个字节是由八个 bit (单个二进制字)组成的:
bytes 类型通常用于处理二进制数据,比如图像文件、音频文件、视频文件等。在网络编程中,也经常使用 bytes 类型来传输二进制数据。例如以二进制读取图片:
with open("photo.png", "rb") as file:
    data = file.read()

print(type(data))  # <class 'bytes'>
创建 bytes 对象最常见的方式是使用 b 前缀:
x = b"hello"           # 使用 b 前缀创建 bytes 对象
print(x)               # b'hello'
print(type(x))         # <class 'bytes'>
print(x[0])            # 104('h' 的 ASCII 值,bytes 元素是整数)
也可以使用 bytes() 函数将其他类型的对象转换为 bytes 类型,第二个参数指定编码方式:
x = bytes("hello", encoding="utf-8")与字符串类型类似,bytes 类型也支持切片、拼接、查找、替换等操作。由于 bytes 类型是不可变的,修改操作需要创建一个新的 bytes 对象:
x = b"hello"
y = x[1:3]          # 切片操作,得到 b'el'
z = x + b"world"    # 拼接操作,得到 b'helloworld'
print(y)            # b'el'
print(z)            # b'helloworld'
需要注意的是,bytes 类型中的元素是整数值,因此在进行比较操作时需要使用相应的整数值。可以用 ord() 函数将字符转换为对应的整数值:
x = b"hello"
if x[0] == ord("h"):    # ord("h") 返回 104
print("第一个元素是 'h'")相应的,chr() 是 ord() 的逆向操作:
print(chr(104)) # hbytearray 是可变字节序列
data = bytearray(b"ABC")
data[0] = 90
print(data)         # bytearray(b'ZBC')
print(bytes(data)) # b'ZBC'十六进制表示:
二进制数据经常使用十六进制显示:
data = bytes([65, 66, 255])
print(data)       # b'AB\xff'
print(data.hex()) # 4142ff
也可以从十六进制字符串创建字节串:
data = bytes.fromhex("41 42 43")
print(data)  # b'ABC'