
写在最前
Python 解释器
先用一句话概括:
Python 解释器(Python Interpreter)是一个读取 Python 程序、分析代码并执行指令的软件。
当你运行:
python hello.py真正工作的不是 hello.py 文件自己,而是 Python 解释器。它会读取源代码(Source Code),把代码转换为适合执行的内部形式,然后完成运算、内存管理、函数调用、异常处理等工作。
Python 语言和 Python 解释器不是一回事
这两个概念非常容易混淆。
Python 语言(Python Language)
Python 语言是一套语法和行为规范(Language Specification),规定:
- 变量怎么定义
if、for、while怎么写- 函数怎么调用
- 类怎么创建
- 异常怎么处理
- 表达式应该得到什么结果
例如:
x = 10
print(x + 5)
这段代码符合 Python 的语言规则。
Python 解释器(Python Interpreter)
解释器是实现这些规则的软件。
可以类比:
Python 语言规范 = 乐谱
Python 程序      = 根据乐谱写出的曲子
Python 解释器    = 演奏曲子的演奏者
同一种 Python 语言可以由不同的解释器实现。
常见的 Python 解释器实现
- CPython
CPython 是最常见、最主流的 Python 实现。
它主要使用 C 语言编写,因此叫:
C + Python = CPython从 Python 官方网站下载安装的 Python,通常就是 CPython。
运行:
python --version只能看到 Python 版本。想确认具体实现,可以执行:
import platform

print(platform.python_implementation())
如果输出:
CPython说明当前使用的是 CPython。
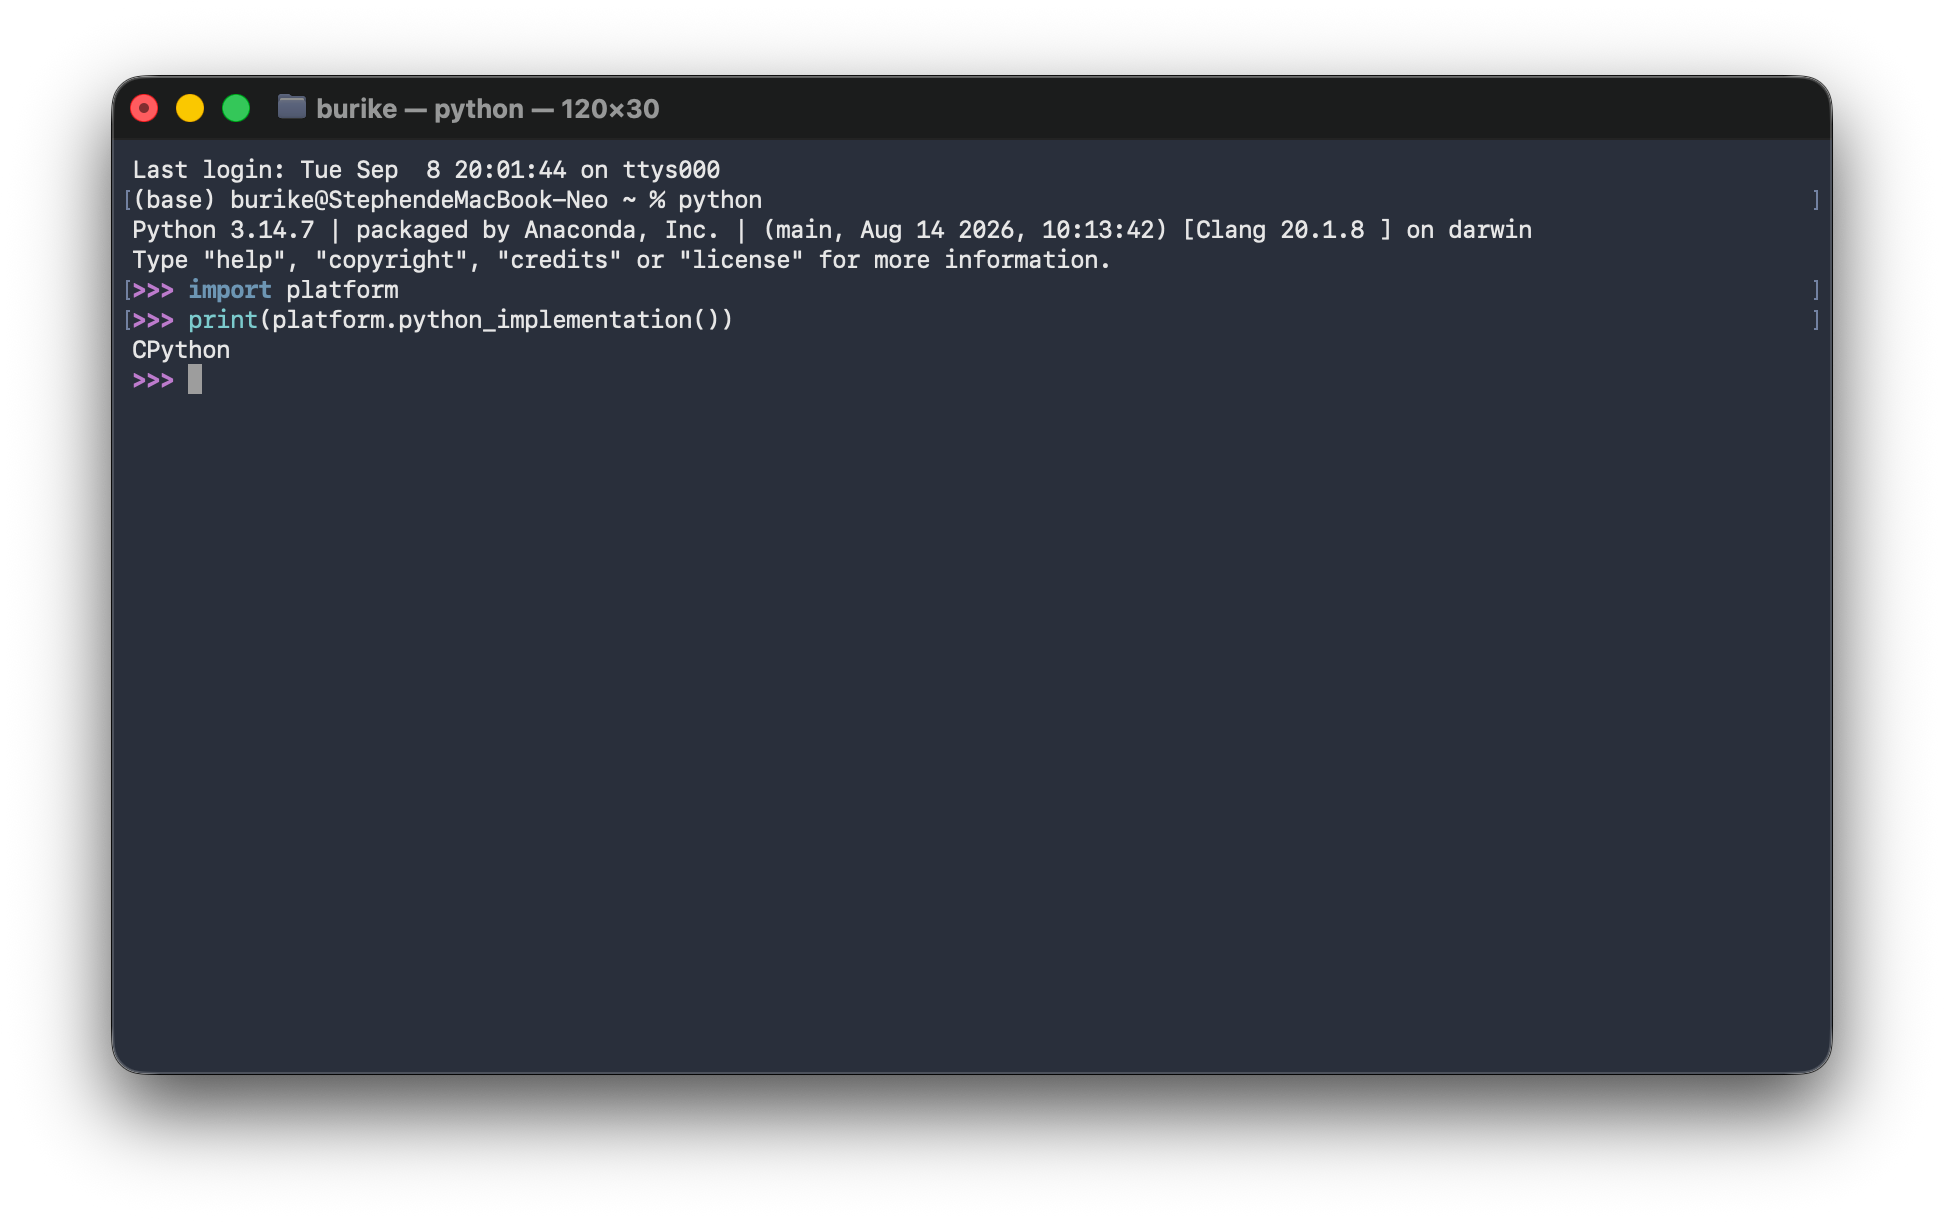
也可以查看完整信息:
import sys

print(sys.implementation)
print(sys.version)
一般学习 Python 时所说的“Python 解释器”,默认指的就是 CPython。
- PyPy
PyPy 是另一种 Python 实现。
它的重要特点是使用即时编译技术:
JIT = Just-In-Time Compilation中文叫“即时编译”。
PyPy 会在程序运行时识别频繁执行的代码,并将部分代码编译成机器码(Machine Code),因此某些计算密集型程序可能比 CPython 更快。
但是:
- 某些第三方扩展的兼容性不如 CPython
- 启动和预热可能需要时间
- 并非所有程序都比 CPython 快
- Jython
Jython 是运行在 Java 虚拟机上的 Python 实现:
JVM = Java Virtual Machine它可以比较自然地调用 Java 类库。
不过,Jython 对较新的 Python 语言版本支持通常不像 CPython 那么及时,因此现在普通 Python 开发较少使用。
- IronPython
IronPython 是面向 .NET 平台的 Python 实现。
它可以与以下技术集成:
- .NET
- C#
- CLR(Common Language Runtime,公共语言运行时)
- MicroPython
MicroPython 是面向微控制器(Microcontroller)和嵌入式设备(Embedded Device)的轻量级 Python 实现。
常见场景包括:
- 单片机
- 传感器
- ESP32
- Raspberry Pi Pico
- 物联网设备
它不是完整的 CPython,一些标准库和语言功能可能受到限制。
CPython 执行代码的完整过程
很多人把 Python 简单描述成:
源代码 → 逐行解释执行这种说法只适合初步理解,但并不完全准确。
以 CPython 为例,执行过程大致是:
Python 源代码
    ↓
词法分析
    ↓
语法分析
    ↓
抽象语法树
    ↓
编译
    ↓
Python 字节码
    ↓
Python 虚拟机执行
对应英文是:
Source Code
    ↓
Lexical Analysis
    ↓
Syntax Analysis / Parsing
    ↓
Abstract Syntax Tree
    ↓
Compilation
    ↓
Python Bytecode
    ↓
Python Virtual Machine
所以,Python 并不是完全“不编译”。
更准确地说:
CPython 通常先把源代码编译成字节码,再由 Python 虚拟机解释执行字节码。
第一步:读取源代码
假设有一个文件:
# hello.py

name = "小明"
age = 18

print(f"{name}今年{age}岁")
解释器首先读取这个源代码文件。
Python 3 的源代码通常使用 UTF-8 编码(UTF-8 Encoding)。
如果文件采用了其他编码,可以在文件开头声明:
# -*- coding: gbk -*-现代 Python 项目通常统一使用 UTF-8,不建议无必要地换用其他编码。
第二步:词法分析
词法分析叫:
Lexical Analysis执行词法分析的程序叫:
Tokenizer / Lexer解释器会把字符序列分割成一个个词法单元:
Token例如:
age = 18 + 2可以被识别为类似下面的 Token:
NAME       age
OPERATOR   =
NUMBER     18
OPERATOR   +
NUMBER     2
关键词也会被识别出来:
if age >= 18:
    print("成年")
里面包含:
if:关键字(Keyword)age:标识符(Identifier)>=:运算符(Operator)18:数值字面量(Numeric Literal)::分隔符(Delimiter)
标识符与关键字的区别
标识符是程序员定义的名称,例如:
student_name
calculate_price
User
关键字是 Python 语法已经占用的单词,例如:
if
else
for
while
def
class
return
try
可以查看所有关键字:
import keyword

print(keyword.kwlist)
第三步:语法分析
语法分析叫:
Syntax Analysis也叫:
Parsing执行语法分析的组件叫:
ParserParser 会检查 Token 的排列是否符合 Python 语法。
例如:
if age >= 18:
    print("成年")
这是合法语法。
而下面缺少冒号:
if age >= 18
    print("成年")
语法分析阶段就会失败,出现:
SyntaxError例如:
SyntaxError: expected ':'这时候程序通常还没有真正开始执行,因为解释器连代码结构都无法正确建立。
第四步:生成抽象语法树 AST
语法分析完成后,Python 会生成抽象语法树:
AST = Abstract Syntax TreeAST 是源代码结构的树状表示。
例如:
result = 1 + 2 * 3解释器不能简单地从左到右计算,因为乘法优先级高于加法。
它建立的结构可以理解为:
Assignment
├── Target: result
└── Value: Add
    ├── Left: 1
    └── Right: Multiply
        ├── Left: 2
        └── Right: 3
因此实际计算的是:
1 + (2 * 3)结果为:
7可以使用标准库中的 ast 模块观察 AST:
import ast

code = "result = 1 + 2 * 3"
tree = ast.parse(code)

print(ast.dump(tree, indent=4))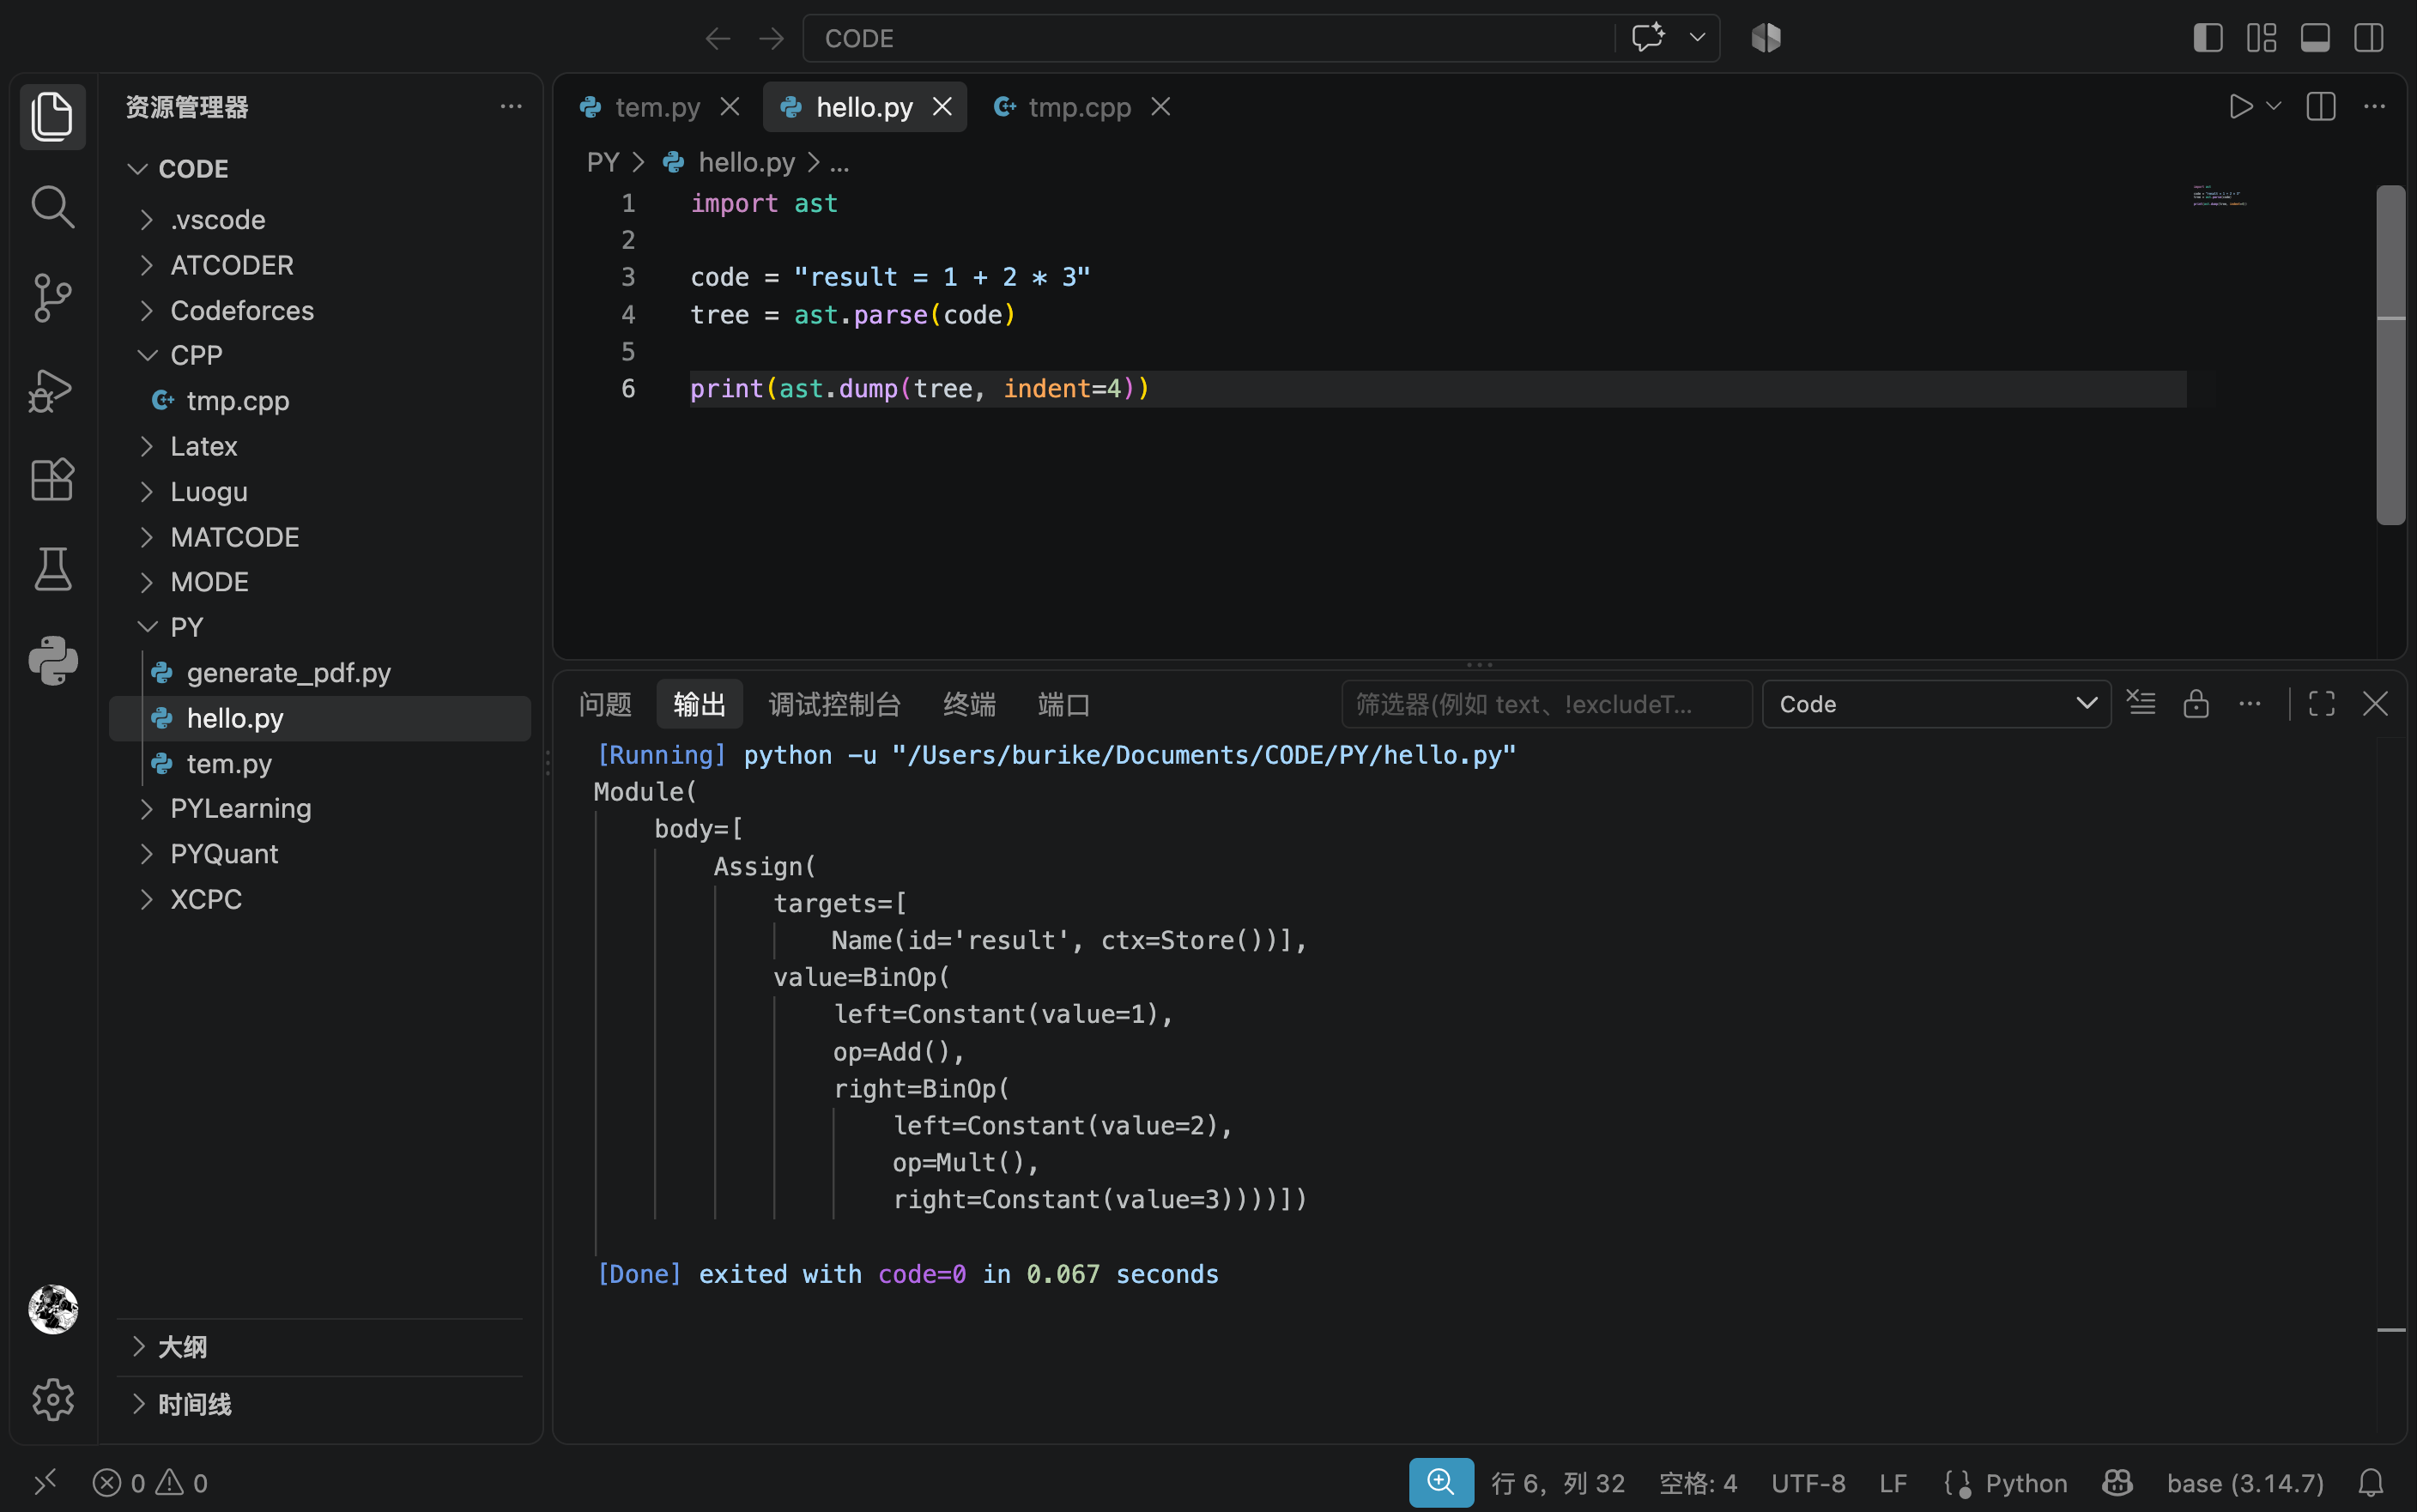
AST 常用于:
- 代码分析(Code Analysis)
- 静态检查(Static Analysis)
- 代码格式化工具(Code Formatter)
- 代码安全检查
- 编译器设计
- IDE 代码提示
- 自动重构(Automated Refactoring)
第五步:编译成字节码
Python 会把 AST 编译成字节码:
Bytecode字节码是介于 Python 源代码和机器码之间的一种中间指令。
例如:
def add(a, b):
    return a + b
可以使用 dis 模块查看字节码:
import dis

def add(a, b):
    return a + b

dis.dis(add)
不同 Python 版本显示结果可能有所不同,但通常能看到类似概念:
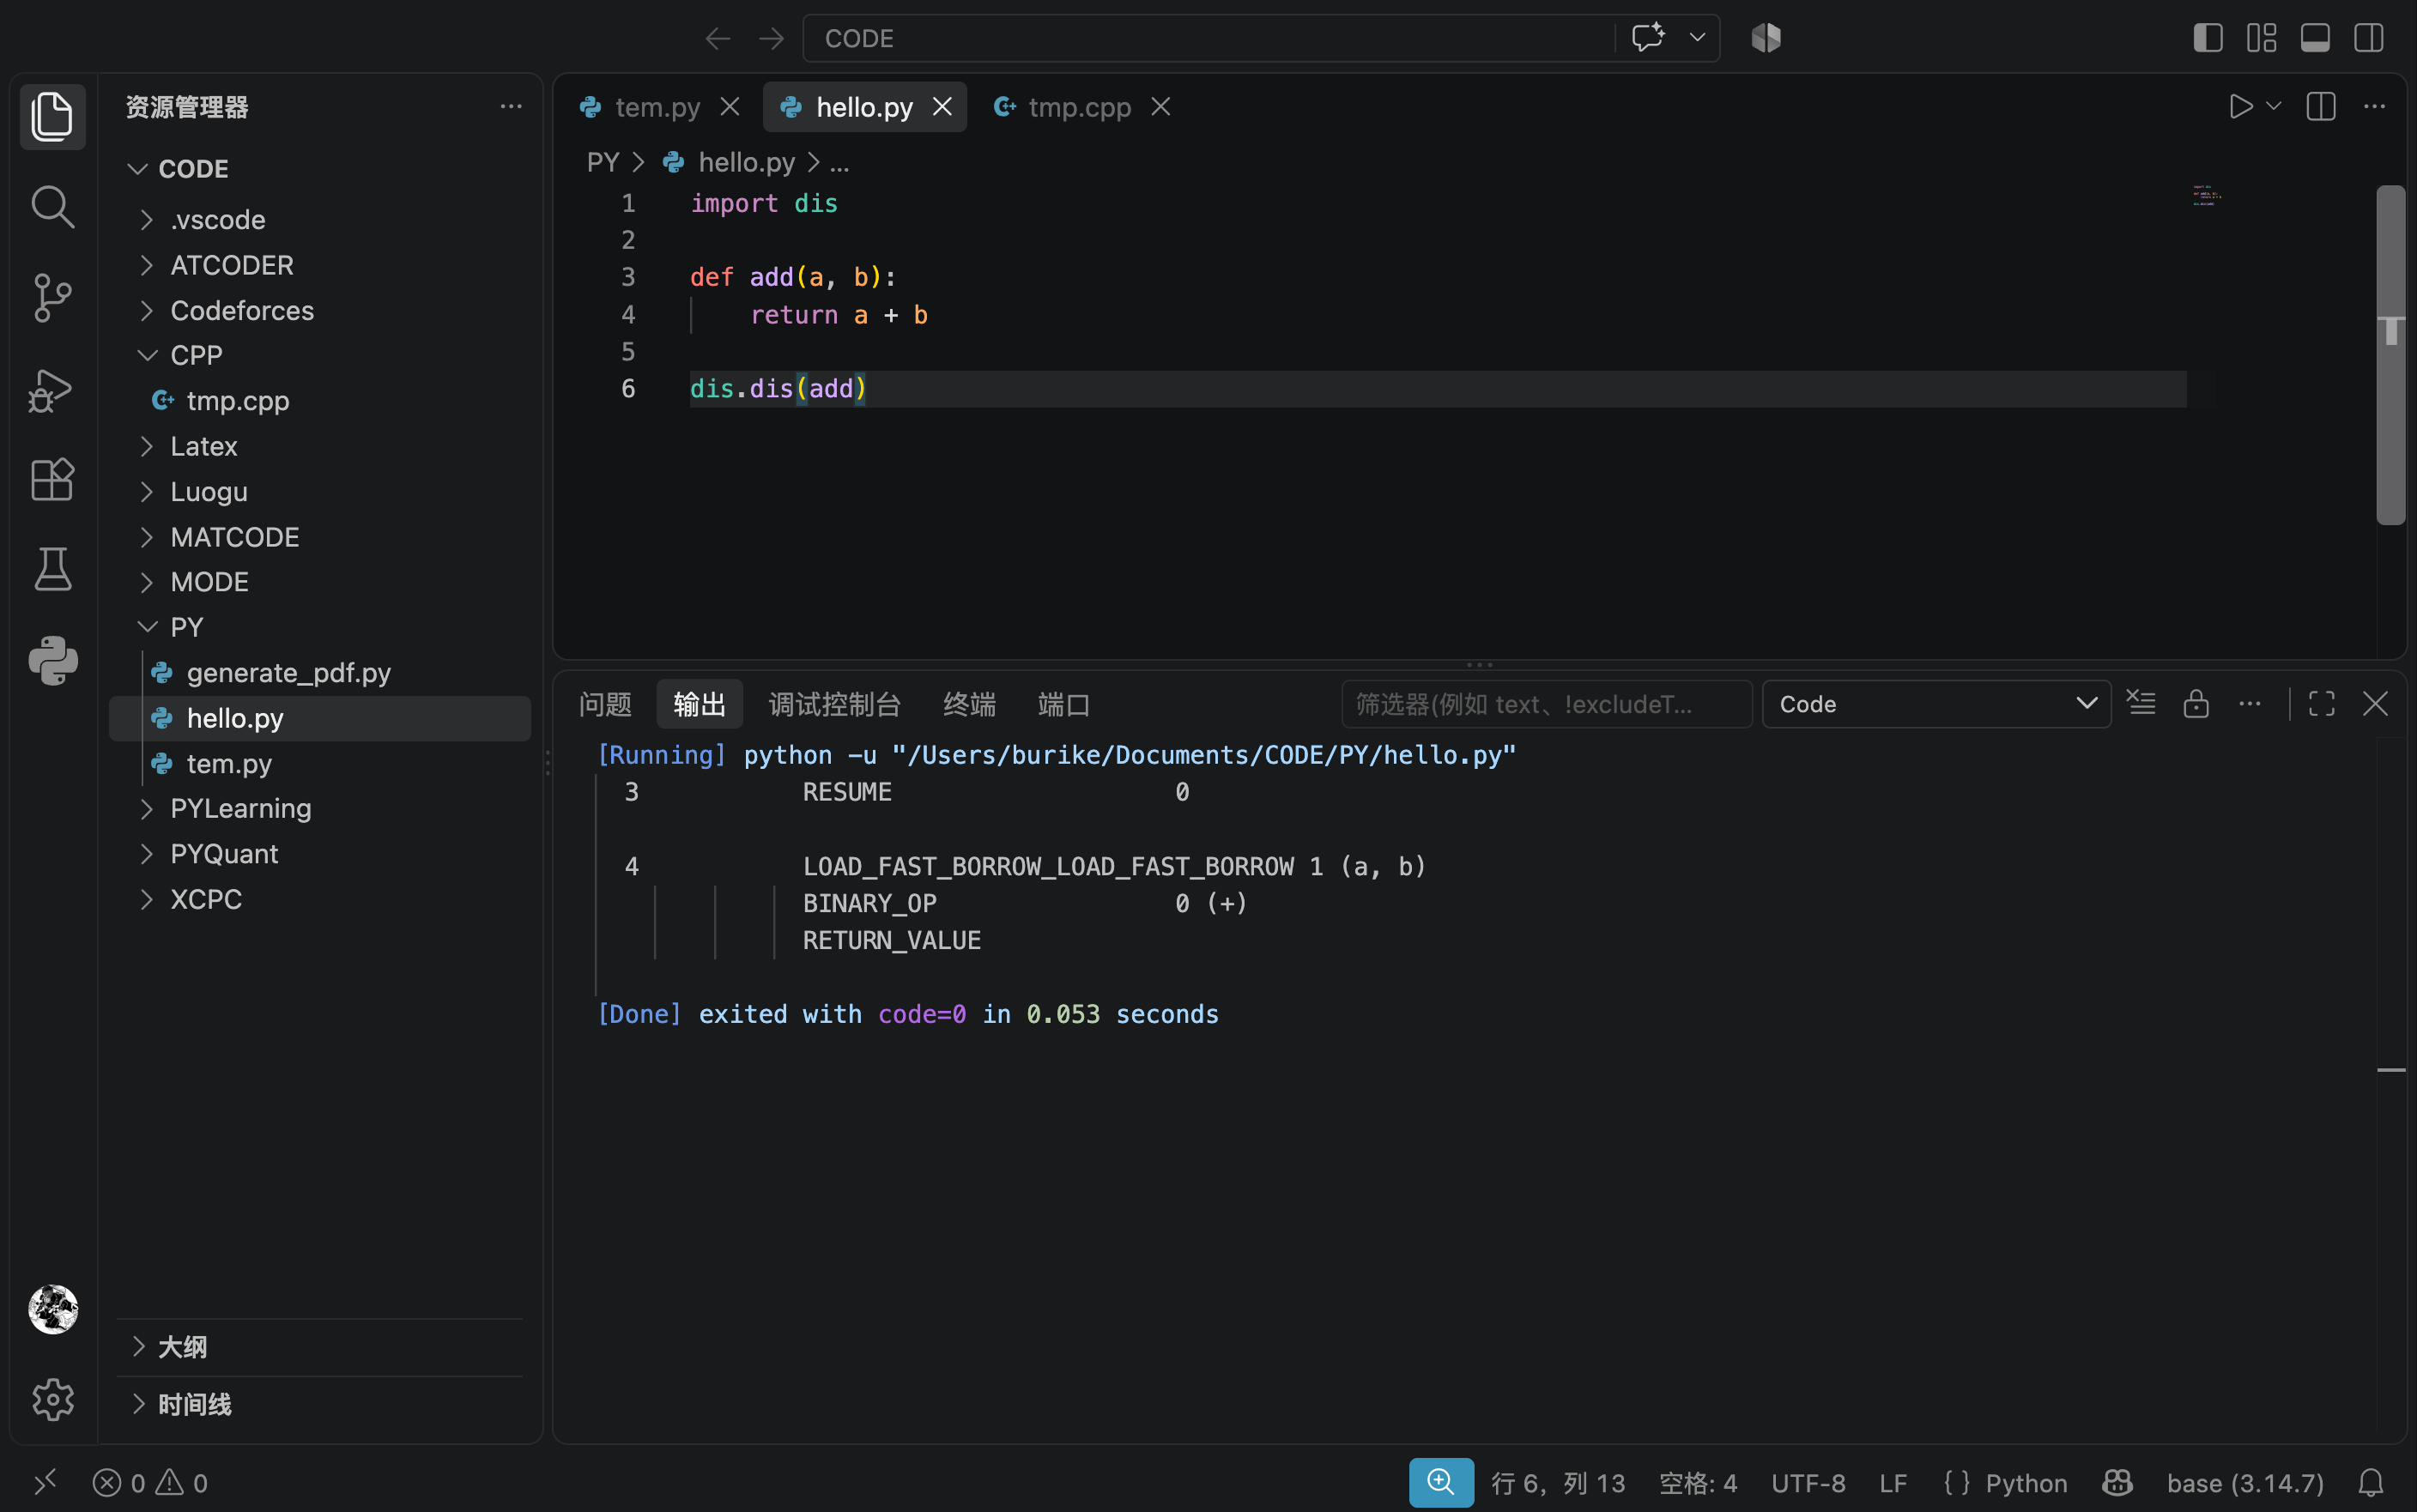
它们大致表示:
LOAD_FAST:读取函数局部变量BINARY_OP:执行二元运算RETURN_VALUE:返回结果
注意:
Python 字节码不是 CPU 可以直接执行的机器码。
CPU 不能直接理解 LOAD_FAST。这些指令需要由 Python 虚拟机继续解释执行。
字节码和机器码有什么区别
机器码(Machine Code)
机器码是处理器可以直接执行的指令。
不同 CPU 架构的机器码可能不同,例如:
- x86-64
- ARM64
- RISC-V
机器码通常与硬件平台密切相关。
Python 字节码(Python Bytecode)
Python 字节码是为 Python 虚拟机设计的指令。
它不直接面向物理 CPU,而是面向:
Python Virtual Machine两者关系可以理解为:
Python 源代码
      ↓
Python 字节码
      ↓
Python 虚拟机
      ↓
本机机器码和系统操作
      ↓
CPU
第六步:Python 虚拟机执行字节码
Python 虚拟机叫:
PVM = Python Virtual Machine这里的“虚拟机”不是 VMware、VirtualBox 那种完整操作系统虚拟机。
PVM 更接近一个字节码执行引擎:
Bytecode Execution Engine它不断完成类似下面的过程:
- 读取一条字节码指令
- 判断指令类型
- 执行相应操作
- 移动到下一条指令
这个过程一般称为:
Evaluation Loop或者:
Interpreter Loop简单理解就是:
取指令 → 解码指令 → 执行指令 → 继续下一条英文可以表示为:
Fetch → Decode → Execute.pyc 字节码缓存文件
运行 Python 项目后,经常会看到:
__pycache__目录中可能有:
module.cpython-313.pyc其中:
.py:Python 源代码文件.pyc:编译后的字节码缓存文件__pycache__:字节码缓存目录
.pyc 的作用
当一个模块被导入时,Python 可能把编译后的字节码保存为 .pyc。
以后再次导入,如果缓存仍然有效,就不需要重新完成全部编译过程,可以直接加载字节码。
因此 .pyc 主要用于:
减少模块加载时的编译开销。
它一般不会让程序主体的运行速度产生巨大提升,因为它主要省略的是从源代码编译成字节码的过程,而不是字节码执行过程。
.pyc 不是机器码
.pyc 文件:
- 不是独立的可执行程序
- 不能代替对应版本的 Python 解释器
- 可能与 Python 版本有关
- 不能当作可靠的源码加密方案
解释执行与编译执行
编译型语言的典型过程
以 C 语言为例:
C 源代码
   ↓
编译器
   ↓
机器码程序
   ↓
CPU 直接执行
编译器英文是:
CompilerCPython 的典型过程
Python 源代码
   ↓
编译成字节码
   ↓
Python 虚拟机解释字节码
因此 Python 同时包含:
- 编译阶段(Compilation Phase)
- 解释执行阶段(Interpretation Phase)
“Python 是解释型语言”是一种方便的分类,但不代表它完全没有编译过程。
更准确地说:
CPython 是先编译为字节码,再解释执行字节码的语言实现。
Python 解释器的使用方式
- 交互式解释器
在终端中输入:
python或某些系统中的:
python3通常会进入:
REPLREPL 全称:
Read-Eval-Print Loop中文可以叫“读取—求值—输出循环”。
它会反复执行:
- Read:读取输入
- Eval:计算或执行
- Print:显示结果
- Loop:继续循环
例如:
>>> 1 + 2
3
>>> name = "小明"
>>> name
'小明'
REPL 适合:
- 快速测试表达式
- 验证语法
- 学习函数用法
- 临时计算
- 调试小段代码
退出方法:
exit()也可以使用终端快捷键:
- macOS/Linux:
Ctrl+D - Windows:
Ctrl+Z后按 Enter
2. 脚本模式
把代码保存为:
hello.py然后运行:
python hello.py这叫脚本模式:
Script Mode适合完整程序和项目开发。
3. 使用 -c 执行代码
python -c "print(1 + 2)"-c 表示直接执行后面的命令字符串。
4. 使用 -m 运行模块
python -m pip --version或者:
python -m http.server-m 的意思是:
按照 Python 的模块查找规则找到模块,然后把它作为程序运行。
这通常比直接运行某个工具脚本更可靠,因为它能明确使用当前 Python 解释器环境中的模块。
解释器、编辑器和 IDE 的区别
这些概念也经常混在一起。
解释器(Interpreter)
负责执行 Python 代码,例如:
CPython
PyPy
编辑器(Editor)
负责编辑代码,例如:
Visual Studio Code
Sublime Text
Vim
集成开发环境(IDE)
IDE 全称:
Integrated Development Environment一般提供:
- 代码编辑
- 自动补全
- 调试
- 项目管理
- 语法检查
- 解释器配置
例如:
PyCharm
Visual Studio Code + Python 扩展
严格来说,VS Code 本身偏向代码编辑器,但安装扩展后可以具备大量 IDE 功能。
重要的是:
PyCharm、VS Code 不等于 Python 解释器,它们需要调用一个已安装或已配置的解释器来运行代码。
关系大致是:
你
↓
IDE / 编辑器
↓
Python 解释器
↓
操作系统和 CPU
解释器路径
一台电脑上可能同时存在多个 Python 解释器,例如:
/usr/bin/python3
/usr/local/bin/python3
项目/.venv/bin/python
可以在 Python 中查看当前解释器路径:
import sys

print(sys.executable)
输出可能类似:
/Users/name/project/.venv/bin/python这非常重要,因为:
你安装包时使用的解释器,应该和运行程序时使用的解释器一致。
例如,下面两条命令未必属于同一个 Python:
pip install requests
python app.py
更稳妥的安装方式是:
python -m pip install requests它明确表示:使用当前这个 python 对应的 pip。
环境变量 PATH
在终端输入:
python操作系统需要知道应该运行哪个 Python 程序。
它通常会根据环境变量:
PATH按顺序查找可执行文件。
macOS/Linux 可以查看:
which python
which python3
Windows 可以查看:
where python不同终端、IDE 或虚拟环境中的 python 命令,可能指向不同解释器。
因此,当出现下面的问题时:
- 明明安装了包却提示找不到
- 终端可以运行,IDE 不能运行
- Python 版本不一致
- 一个项目正常,另一个项目报错
第一件值得检查的事情通常是:
import sys

print(sys.executable)
print(sys.version)
虚拟环境和解释器
虚拟环境叫:
Virtual Environment常见创建方式:
python -m venv .venv虚拟环境的作用是为项目提供相对独立的:
- Python 命令入口
- 第三方包安装位置
- 依赖环境
可以理解为:
项目 A
├── 自己的虚拟环境
└── 自己版本的第三方包

项目 B
├── 自己的虚拟环境
└── 自己版本的第三方包
它主要隔离的是第三方包,而不一定复制一套完整的 Python 安装。
激活虚拟环境后:
python通常会指向虚拟环境中的解释器入口。
可通过下面的代码确认:
import sys

print(sys.executable)
print(sys.prefix)
print(sys.base_prefix)
一般情况下:
sys.prefix:当前环境位置sys.base_prefix:基础 Python 环境位置- 二者不同时,通常表示处于虚拟环境中
例如:
if sys.prefix != sys.base_prefix:
    print("当前处于虚拟环境")
Python 解释器怎样管理变量
执行:
x = 100不要简单理解为“把 100 放进变量盒子 x”。
更准确的说法是:
- Python 创建或取得整数对象
100 - 在当前命名空间中建立名字
x - 让名字
x引用这个对象
这里涉及三个专业概念:
- 对象(Object)
- 引用(Reference)
- 名字绑定(Name Binding)
可以理解为:
名字 x ─────→ 整数对象 100再执行:
y = x通常不是立刻复制一个新的整数对象,而是让 y 也引用相应对象:
名字 x ──┐
         ├──→ 整数对象 100
名字 y ──┘
这也是理解列表赋值问题的关键:
a = [1, 2]
b = a

b.append(3)

print(a)  # [1, 2, 3]
因为 a 和 b 引用了同一个列表对象。
命名空间与作用域
解释器需要记录“一个名字对应哪个对象”,保存这种映射关系的地方叫:
Namespace中文叫“命名空间”。
例如:
name = "全局变量"

def test():
    age = 18
这里至少涉及:
- 全局命名空间(Global Namespace)
- 局部命名空间(Local Namespace)
Python 查找名字时遵循常说的:
LEGB Rule分别是:
L:Local,局部作用域E:Enclosing,外层函数作用域G:Global,全局作用域B:Built-in,内置作用域
例如:
name = "全局"

def outer():
    name = "外层"

    def inner():
        name = "局部"
        print(name)

    inner()

outer()
输出:
局部因为解释器先在 Local 中找到 name,就不再继续向外查找。
调用函数时会发生什么
例如:
def add(a, b):
    result = a + b
    return result

answer = add(10, 20)
调用 add(10, 20) 时,解释器大致会:
- 找到函数对象
add - 创建函数调用帧
- 将
a绑定到10 - 将
b绑定到20 - 建立函数的局部命名空间
- 执行函数体
- 计算
a + b - 将结果绑定到
result - 执行
return - 返回调用位置
函数调用帧叫:
Stack Frame简称:
Frame函数调用会形成调用栈:
Call Stack例如:
def a():
    b()

def b():
    c()

def c():
    print("执行 c")

a()
调用栈可以理解为:
全局代码
└── a()
    └── b()
        └── c()
如果发生异常,Python 显示的:
Traceback本质上就是相关调用栈信息。
异常是怎样传播的
例如:
def divide(a, b):
    return a / b

def calculate():
    return divide(10, 0)

calculate()
divide() 中会产生:
ZeroDivisionError如果当前函数没有捕获异常,解释器会沿调用栈向外寻找异常处理器:
try:
    calculate()
except ZeroDivisionError:
    print("除数不能为 0")
这个过程叫:
Exception Propagation中文叫“异常传播”。
如果一直没有找到匹配的 except,解释器会:
- 终止当前程序
- 输出异常类型
- 输出异常信息
- 输出调用追踪信息(Traceback)
解释器的内存管理
Python 解释器还负责对象的内存管理:
Memory Management在 CPython 中,一个重要机制是:
Reference Counting中文叫“引用计数”。
解释器会大致记录一个对象被多少地方引用。
a = [1, 2, 3]
b = a
此时列表对象至少被 a 和 b 引用。
del a只是删除名字 a 的绑定,不一定立即删除列表对象,因为 b 仍然引用它。
del b当对象引用计数降为零时,CPython 通常可以释放对象。
但是,单纯引用计数不能很好地处理循环引用:
a = []
b = []

a.append(b)
b.append(a)
因此 Python 还具有垃圾回收机制:
Garbage Collection其中包含针对循环引用的处理。
需要注意:
del x的核心作用是删除名字绑定,不等于无条件立即释放对象。
动态类型与解释器
Python 是动态类型语言:
Dynamically Typed Language例如:
x = 10
x = "hello"
同一个名字 x 可以先后引用不同类型的对象。
更准确地说:
Python 的对象具有类型,变量名本身通常没有固定类型。
x = 10可以理解为:
x → int 对象之后:
x = "hello"变成:
x → str 对象类型检查和大量运算决定会在运行时发生:
RuntimeError例如:
x = 10
y = "20"

print(x + y)
执行到加法时,解释器发现 int 和 str 不能这样相加,于是抛出:
TypeError导入模块时解释器做了什么
执行:
import math解释器大致会:
- 检查模块是否已经加载
- 根据模块查找路径寻找
math - 加载或初始化模块
- 创建模块对象
- 把模块对象放入模块缓存
- 将名字
math绑定到当前命名空间
已加载模块主要记录在:
import sys

print(sys.modules)
模块搜索路径主要在:
import sys

for path in sys.path:
    print(path)
当出现:
ModuleNotFoundError常见原因包括:
- 模块没有安装
- 安装到了另一个解释器
- 当前虚拟环境不正确
- 项目路径配置不正确
- 文件名或包结构有问题
__name__ == "__main__" 与解释器
常见代码:
def main():
    print("程序开始")

if __name__ == "__main__":
    main()
当文件被直接运行时:
python app.py解释器通常把这个模块的 __name__ 设置为:
"__main__"所以 main() 会执行。
但如果被其他文件导入:
import app此时 app 模块中的:
__name__通常是:
"app"条件不成立,因此 main() 不会自动调用。
它的作用是区分:
- 文件被直接运行
- 文件被当作模块导入
GIL 是什么
在传统 CPython 中,经常会遇到:
GIL = Global Interpreter Lock中文叫“全局解释器锁”。
可以先这样理解:
在传统 CPython 的同一个解释器进程中,GIL 通常限制多个线程同时执行 Python 字节码。
例如创建多个线程:
import threading并不意味着多个线程中的 Python 字节码一定会在多个 CPU 核心上同时执行。
但是这不表示 Python 线程完全没有意义。
线程很适合 I/O 密集型任务:
I/O-bound Tasks例如:
- 网络请求
- 读取文件
- 等待数据库
- 等待用户输入
CPU 密集型任务:
CPU-bound Tasks例如:
- 大量纯 Python 数值计算
- 图像逐像素处理
- 复杂循环计算
传统 CPython 中,这类任务常考虑:
- 多进程(Multiprocessing)
- 使用能够释放 GIL 的扩展库
- 使用其他实现或编译技术
GIL 属于 CPython 实现细节,不是 Python 语言语法本身。
解释器和操作系统的关系
Python 程序经常需要:
- 打开文件
- 创建进程
- 建立网络连接
- 获取系统时间
- 申请内存
这些能力最终需要操作系统提供。
关系可以概括为:
Python 程序
    ↓
Python 解释器和标准库
    ↓
操作系统接口
    ↓
硬件
例如:
with open("data.txt", "r", encoding="utf-8") as file:
    content = file.read()
表面上调用的是 Python 的 open(),但底层会进一步使用操作系统的文件访问能力。
解释器和 Shell 的区别
终端中可能看到:
%
$
>
C:\>
这通常是 Shell 的提示符。
常见 Shell 包括:
- Bash
- Zsh
- PowerShell
- Command Prompt
在 Shell 中输入:
python app.py含义是:
让 Shell 启动 Python 解释器,并把
app.py作为参数交给它。
进入 Python 后看到:
>>>这才是 Python 交互式解释器提示符。
不要混淆:
Shell 命令:
python app.py

Python 代码:
print("hello")
如果在 Python 的 >>> 中输入:
python app.py会出现语法错误,因为这不是 Python 语法,而是 Shell 命令。
常见解释器相关命令
查看 Python 版本:
python --version查看解释器路径:
import sys
print(sys.executable)
查看更完整的版本信息:
import sys
print(sys.version)
查看 Python 实现:
import platform
print(platform.python_implementation())
查看模块搜索路径:
import sys
print(sys.path)
查看已经导入的模块:
import sys
print(sys.modules)
检查虚拟环境:
import sys

print(sys.prefix)
print(sys.base_prefix)
查看字节码:
import dis

def add(a, b):
    return a + b

dis.dis(add)
查看抽象语法树:
import ast

tree = ast.parse("x = 1 + 2")
print(ast.dump(tree, indent=4))
写在最后
Python 解释器不只是“逐行翻译代码”的工具。它实际上包含源码分析、字节码编译、虚拟机执行、对象管理、函数调用、异常处理、模块导入和内存管理等一整套运行时系统(Runtime System)。